テキストを抽出する Word - ドキュメントコンテンツ Zapier
PDF4me テキストを抽出する Word アクションはMicrosoftからテキストを取得します Word ドキュメント (.docx) Zapierページ範囲(開始/終了)を設定し、必要に応じてコメント、ヘッダー/フッターを削除し、変更履歴を受け入れてクリーンなコンテンツを抽出します。コンテンツ分析、AI処理、検索インデックス作成、データ移行、またはドキュメントテキストのフィードに最適です。 CRMスプレッドシートや自動化ツールなど。
主な機能
- ページ範囲制御: 開始ページから終了ページまで抽出します。
-1最終ページへ - クリーンな出力コメント、ヘッダー、フッターを削除して本文のみを抽出します
- 変更履歴出力における追跡対象の変更を受け入れるか除外するか
- 動的入力: 地図 Word Dropbox、Google Drive、フォーム、またはメールからのファイル
- 下流工程対応出力先は、スプレッドシート、エアテーブル、AI、検索、またはウェブフックです。
認証 API リクエスト
アクセスするには PDF4me ウェブ API を通して Zapierすべてのリクエストには、適切な認証情報を含める必要があります。
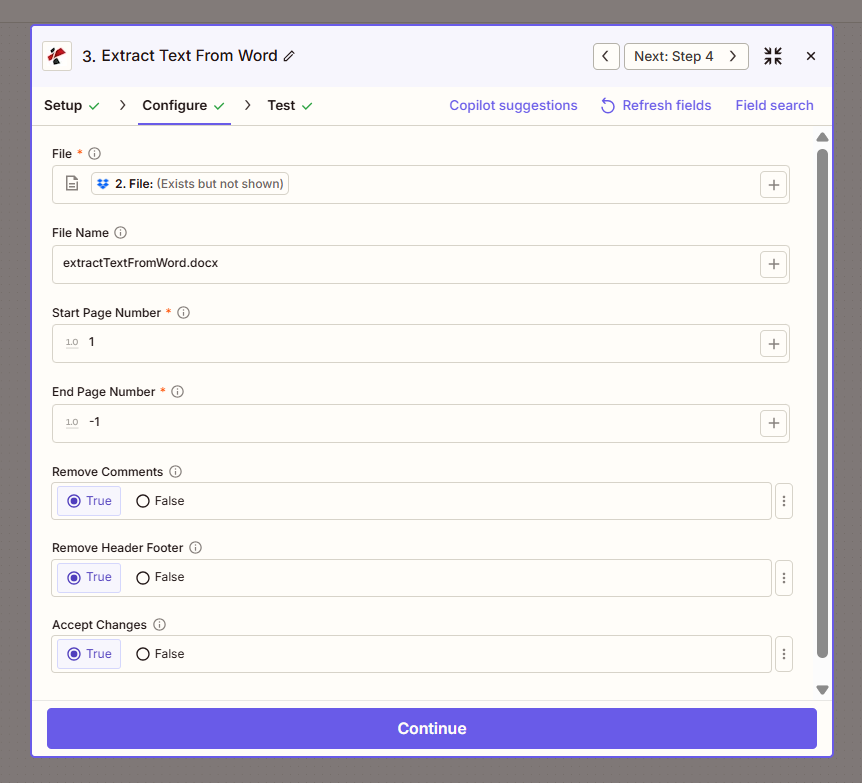
設定手順: ファイル、ページ範囲、コメントの削除、ヘッダー/フッターの削除、変更の承認。
:::ヒント 前の手順のマップファイルを使用します + 地図ボタン ファイル 以前の Zap ステップ (Drive、Dropbox、トリガー) から。 Wordファイルには完全なコンテンツを提供する必要があり、「存在するが表示されない」参照は認められません。 :::
:::警告 ファイル: (存在しますが表示されません) 「ファイル: (存在しますが表示されません)」が表示され、エラーが発生した場合は、 ファイルの内容全体。 見る Zapier & Power Automate ヒント詳細は :::
設定項目(事実確認済み)
重要: アスタリスク(*)が付いているパラメータは必須項目です。
必須項目
| パラメータ | タイプ | 必須 | 説明 | UIからの例 |
|---|---|---|---|---|
| ファイル | ファイル | いいえ | 入力 Word (.docx)前のステップから | 2. File: (Exists but not shown) |
| 開始ページ番号* | 番号 | はい | 抽出する最初のページ(1ベース) | 1 |
| 最終ページ番号* | 番号 | はい | 最終ページ。 -1 ドキュメントの終わりまで | -1 |
オプション項目
| パラメータ | タイプ | 必須 | 説明 | UIからの例 |
|---|---|---|---|---|
| ファイル名 | 文章 | いいえ | 出力識別子 | extractTextFromWord.docx |
| コメントを削除 | 正誤 | いいえ | 抽出したテキストからコメントを除外します。デフォルトは「はい」です。 | True |
| ヘッダーとフッターを削除 | 正誤 | いいえ | ヘッダーとフッターを除外します。デフォルトは「はい」です。 | True |
| 変更を受け入れる | 正誤 | いいえ | 承認された変更履歴を出力に含めます。デフォルトは「はい」です。 | True |
| ファイル URL (ファイルまたはファイルを提供する) URL) | 文章 | いいえ | リンク先 Word テキストを抽出するドキュメント(ファイルの代替として)。ファイルをマッピングします。 URL 前のステップから。 |
トラブルシューティング
-1 「最終ページ」を意味し、開始ページから文書の末尾までを抽出します。明示的な番号を使用します(例: 5抽出を特定のページに限定するため。
設定 真実 クリーンな本文テキスト用(検索、分析、AIなど)。 間違い メタデータを含む文書の全内容が必要な場合。
抽出したテキストをGoogleスプレッドシート、Airtable、メール、またはAIツールにマッピングします。 OCR スキャンされたコンテンツには、 変換する PDF それから テキストを抽出する PDF 画像ベースのドキュメント向け。
出力
の PDF4me テキストを抽出する Word このアクションは抽出されたテキストを返します。分析、保存、または処理のために、次のステップにマッピングしてください。
- Table
- Workflow Usage
| パラメータ | タイプ | 説明 |
|---|---|---|
| ジョブID | 文章 | ID PDF4me リクエストを処理したジョブ。 |
| トレースID | 文章 | リクエストのトレースID、 PDF4me 1を返します。 PDF4me 問題を報告する際のサポート。 |
| ドキュメントID | 文章 | ID PDF4me 結果として得られる文書を返します。 |
| ファイル名 | 文章 | 拡張子を除いた、生成されるファイル名。 |
| ファイル拡張子 | 文章 | 結果として得られるファイルの拡張子、例えば .pdf。 |
| ファイル名全体 | 文章 | 生成されるファイルの名前(拡張子を含む)。 |
| ファイルURL | 文章 | 結果ファイルのダウンロードリンク。このリンクを、Google ドライブへのアップロードなど、ファイルが必要な後続のステップにマッピングします。 Dropbox または OneDrive。 |
| 代替ファイルURL | 文章 | 結果ファイルの代替ダウンロードリンク。ファイル名は末尾に URL。 |
| ファイルサイズ | 番号 | 結果として得られるファイルのサイズは、 PDF4me。 |
- Googleスプレッドシート/エアテーブル検索または監査のために文書の内容を保存する
- AI / LLM: テキストをChatGPT、Claude、またはカスタムAIに入力して分析する
- 検索検索エンジンまたは内部検索でコンテンツをインデックス化する
- メール抽出したテキストを通知やレポートに含める
- CRM連絡先/アカウントレコードにドキュメントの要約またはコンテンツを追加する
- Webhook: テキストをカスタムに送信する API処理用のs
ワークフローの例
- Content to Sheets
- AI Analysis
- CMS Migration
Google スプレッドシートの検索用コンテンツ
- トリガー: 新しい Word フォルダ内のドキュメント(提案書、契約書)
- テキストを抽出する Word: 開始 1、終了 -1、コメント/ヘッダー/フッターを削除 = True
- Googleスプレッドシートファイル名と抽出したテキストを含む行を追加します
- オプション検索、重複検出、または分析に使用します。
利点検索可能な文書登録システム。手動でのコピー&ペーストは不要です。
受信文書のAI分析
- トリガー: Word フォームまたはメールに添付されたドキュメント
- テキストを抽出する Word: 文書全体
- OpenAI / AI要約、分類、または抽出のためにテキストを送信します。
- CRM またはデータベース: AIの出力をドキュメント参照とともに保存する
利点: 自動化された文書分析機能。より迅速なトリアージ。
コンテンツをCMSまたはWikiに移行する
- トリガー: Word フォルダ内のファイル(レガシーコンテンツ)
- テキストを抽出する Word必要に応じてページ範囲を指定
- フォーマッター: テキストを整理または構造化する
- CMS / Confluence / Notes抽出したコンテンツを含むページを作成する
利点一括移行により、手動変換作業を削減できます。
業界における活用事例
- Legal
- HR
- Publishing
- Education
- Consulting
法律上の
法律事務所や企業の法務チームは、契約書、修正契約書、法的覚書からテキストを抽出し、条項の比較、デューデリジェンス、契約分析に活用しています。Wordからテキストを抽出する機能を使えば、本文コンテンツ(コメントとヘッダー/フッターの削除を有効にした状態)を抽出し、AIツールに入力して要約、リスクフラグ付け、条項抽出を行うことができます。契約ライフサイクル管理システムとの連携、検索可能な契約リポジトリの構築、一次レビューワークフローの自動化も可能です。特定のセクション(添付資料など)のみが必要な場合は、ページ範囲指定による抽出にも対応しています。
人事部
人事部門は、職務記述書、ポリシー文書、ハンドブック、研修資料などを処理します。「Word からテキストを抽出」機能は、検索インデックス作成、コンプライアンスチェック、AI による分析のためにコンテンツを抽出します。検索可能なポリシーデータベースを構築したり、求人マッチングシステム用のキーワードを抽出したり、従業員セルフサービスのためにハンドブックをチャットボットに取り込んだりできます。ヘッダーとフッターを削除して本文をきれいに表示したり、ページ範囲を使用してポリシーセクションや付録のみを処理したりすることも可能です。人事情報システム (HRIS)、イントラネット、学習管理システムと連携します。
出版
出版社やコンテンツチームは、原稿、記事、従来の Word 文書を CMS プラットフォーム (WordPress、Drupal)、Wiki (Confluence、Notion)、または構造化フォーマットに移行します。Extract Text From Word はインポート用の生コンテンツを提供し、Formatter の手順を使用して、CMS にアップロードする前にマークアップをクリーンアップしたり、見出しごとに分割したり、構造を正規化したりできます。バックカタログの一括移行、著者投稿の Web フォーマットへの変換、コンテンツ配信ワークフローをサポートします。ページ範囲を使用して、表紙や付録を除外できます。
教育
教育者や教育設計者は、シラバス、コースパック、課題からテキストを抽出し、LMSへのインポート、盗用チェック、アクセシビリティ分析に活用できます。コンテンツを学習管理システムに取り込んだり、課題をオリジナリティチェックツールに入力したり、読みやすさや構造を分析したりすることも可能です。ヘッダーやフッターを削除して、クリーンな抽出を実現します。開始ページと終了ページを使用して、関連するセクションのみを処理することもできます。カリキュラムのデジタル化、コースの更新、複数のコースや教育機関にわたるコンテンツの再利用をサポートします。
コンサルティング
コンサルティング会社や専門サービス会社は、提案書、レポート、成果物文書を処理します。Extract Text From Word は、エグゼクティブ サマリー、競合分析、ナレッジ ベースのインデックス作成のために、コンテンツを AI に供給します。検索可能な提案ライブラリを構築したり、クライアント ポータルのレポート要約を自動化したり、主要な指標や推奨事項を抽出したりできます。 CRM 統合。最終版抽出時には、変更履歴とコメントを削除します。セクションごとの処理にはページ範囲を使用します。
関連アクション
- テキストを抽出する PDF: 抜粋 PDFs
- 変換する PDF: 変換する Word に PDF 初め
- ドキュメントを解析する: 文書からの構造化データ抽出