得る PDF メタデータ - プロパティリーダー Zapier
PDF4me 得る PDF メタデータ アクションは包括的なドキュメントインテリジェンスを提供します Zapier 完全な自動抽出 PDF 高度な文書管理とワークフロー自動化のための、文書プロパティ、技術仕様、セキュリティ属性、ファイル特性などのメタデータ。この強力な検査サービスは、タイトル、作成者、件名、キーワード、ページ数、作成日と変更日を取得します。 PDF バージョン、暗号化ステータス、線形化、デジタル署名、ファイルサイズ、および PDF/ 元の文書を変更せずにコンプライアンス情報を取得し、文書カタログシステム、品質検証ワークフロー、コンプライアンス検証プロセス、インテリジェントな文書ルーティングの取り扱い方法を変革します。 PDF 物件。何千もの物件を自動的にカタログ化しているかどうか PDF検索可能なドキュメントライブラリの抽出メタデータを使用して検証します。 PDF 規制当局への提出前のコンプライアンス要件、暗号化または署名ステータスに基づいて文書を異なるワークフローにルーティングしたり、包括的な技術仕様を含む文書インベントリレポートを生成したりする際に、この機能は手作業を排除します。 PDF 検査を実施しながら、高度な文書管理の自動化とインテリジェントなビジネスロジックに必要な豊富なメタデータ基盤を提供する。
認証 API リクエスト
アクセスするには PDF4me ウェブ APIすべてのリクエストには、適切な認証情報を含める必要があります。認証は安全な通信を保証し、あなたが正規のユーザーであることを証明します。
主な機能
- 包括的なメタデータ: すべて抽出 PDF 文書のプロパティと技術的属性
- セキュリティ情報暗号化、パスワード保護、デジタル署名を検出する
- 技術仕様: 取得 PDF バージョン、コンプライアンス、および線形化ステータス
- ファイルプロパティページ数、ファイルサイズ、作成日、更新日を取得します。
- 非破壊: 元のデータを変更せずにメタデータを抽出します PDF
パラメータ
Get のパラメータの完全なリスト PDF メタデータ操作。これらのパラメータを設定して、メタデータの抽出を制御します。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
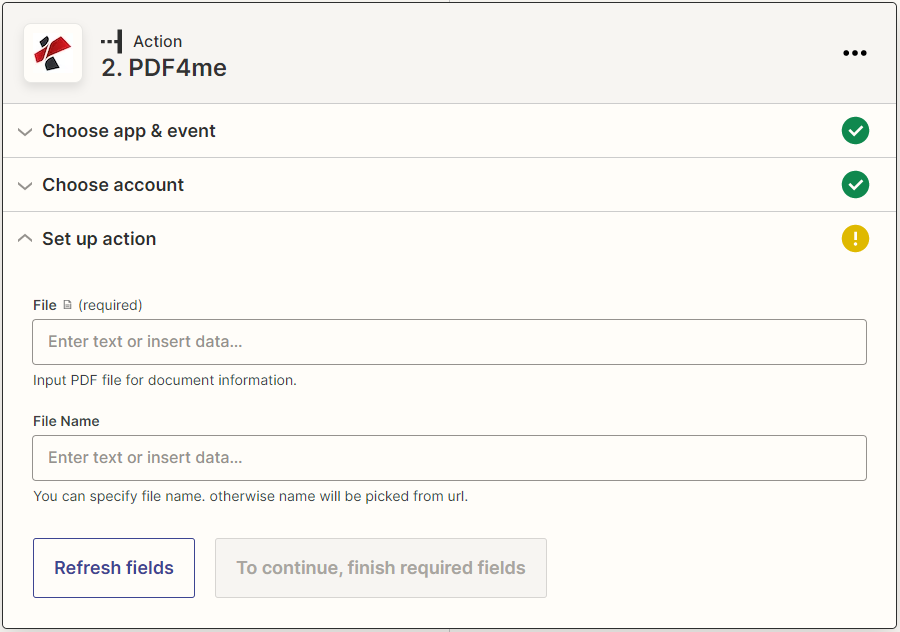
| ファイル* | ファイル | 地図 PDF メタデータ抽出用のファイル | [PDF File] |
| ファイル名 | 文章 | 識別用のファイル名を指定してください。指定しない場合は、ファイルフィールドから名前が選択されます。 | document.pdf |
出力
の PDF4me 得る PDF メタデータ アクションは、シームレスな包括的なメタデータを返します Zapier ワークフロー統合:
- Table
- JSON
テーブルビュー
抽出された完全なメタデータフィールド PDF:
| パラメータ | タイプ | 説明 |
|---|---|---|
| タイトル | 文章 | タイトルは保存されています PDF 特性。 |
| 主題 | 文章 | 対象は PDF 特性。 |
| ページ数 | 番号 | ページ数 PDF。 |
| 著者 | 文章 | 著者は保存されています PDF 特性。 |
| 作成に使用 | 文章 | 元の文書が作成されたアプリケーション。 |
| 制作: | 文章 | 生成されたアプリケーション PDF。 |
| 作成日 | 文章 | 作成日は PDF。 |
| 更新日 | 文章 | 最終更新日は PDF。 |
| ファイルサイズ | 番号 | サイズ PDF報道によると PDF4me。 |
| 暗号化されています | 正誤 | 真の場合 PDF 暗号化されています(パスワードで保護されています)。 |
| 高速ウェブビュー | 正誤 | 真の場合 PDF 線形化されています(高速なウェブ表示に最適化されています)。 |
| PDF準拠レベル | 文章 | PDF/適合レベル PDF(もしあれば) |
| 署名済み | 正誤 | 真の場合 PDF デジタル署名が含まれています。 |
| PDF版 | 文章 | PDF ファイルのバージョン、例えば 1.7。 |
JSON 回答形式
{
"Title": "Annual Report 2025",
"Subject": "Financial Performance",
"Author": "Finance Department",
"Creator": "Microsoft Word",
"Producer": "Adobe PDF Library",
"Page Count": 45,
"Creation Date": "2025-01-15T10:30:00Z",
"Mod Date": "2025-01-16T14:20:00Z",
"File Size": 2458960,
"Is Encrypted": false,
"Is Linearized": true,
"Is Signed": false,
"PDF Version": "1.7",
"PDF Compliance": "PDF/A-2b"
}
ワークフローの例
の PDF4me 得る PDF メタデータ アクション Zapier 実際のビジネスシナリオに合わせて設計された包括的なワークフローテンプレートを提供します。
- Automated Document Cataloging
- Document Quality Validation
- PDF Security Auditing
- Intelligent Document Routing
自動化 PDF 図書館目録作成ワークフロー
インテリジェントなメタデータ抽出機能で文書管理を変革し、包括的な文書カタログを作成しましょう。
ワークフローの手順を完了する:
- トリガー: 新しい PDF 文書が文書管理システムにアップロードされました
- 抽出するタイトル、著者、主題、日付を含む完全なメタデータを取得します。
- 解析メタデータからキーワードと分類データを抽出します。
- 豊かにする: 抽出したメタデータをドキュメントデータベースレコードに追加します
- 索引: すべてのメタデータフィールドを含む検索可能なカタログエントリを作成します
- タグ主題と著者情報に基づいて自動的にタグを適用する
- 整理するメタデータに基づいて適切なフォルダにドキュメントを保存する
- 有効にするユーザーがタイトル、著者、主題、またはキーワードで検索できるようにする
ビジネス上のメリット:
- メタデータ抽出機能を備え、毎月1000件以上の文書のカタログ作成を自動化します。
- 豊富なメタデータインデックスによる高度な文書検索を可能にする
- メタデータの手動入力が不要になり、文書1件あたり10分の時間を節約できます。
- 検索可能な包括的なドキュメントライブラリを自動的に作成します
自動化 PDF 品質管理ワークフロー
文書のコンプライアンスチェックのためのインテリジェントなメタデータ検証で、品質保証を効率化しましょう。
ワークフローの手順を完了する:
- トリガー: PDF 出版または配布のために提出された文書
- 抽出するページ数、バージョン、コンプライアンスなどのメタデータを取得します。
- 検証するページ数が最低要件を満たしているか確認してください。
- 確認する: 確保する PDF システムとのバージョン互換性
- チェック: 検証する PDF/アーカイブに必要な場合は準拠
- 評価ファイルサイズが許容範囲内であることを確認してください。
- 報告: 合格/不合格ステータスを含む品質検証レポートを生成する
- ルート: 準拠を承認する PDFs、修正が必要な不適合フラグ
ビジネス上のメリット:
- 毎月500件以上の文書の品質検証を自動化します。
- 法令違反の公表を防止する PDFs
- 自動検証により品質問題を95%削減
- 組織全体で一貫した文書基準を確保する
自動化 PDF セキュリティステータス監査ワークフロー
暗号化、保護、署名の状態をインテリジェントに検出することで、文書のセキュリティを最適化します。
ワークフローの手順を完了する:
- トリガー: PDF セキュリティコンプライアンスチェックが必要な文書が到着しました。
- 抽出する暗号化や署名ステータスなどのセキュリティメタデータを取得します。
- 検出する: 文書がパスワードで保護されているか、暗号化されているかを確認します。
- 確認するデジタル署名の有無と有効性を確認する
- 評価セキュリティが組織の要件を満たしているかどうかを判断する
- フラグ機密文書に必要な暗号化が施されていない場合は警告を発する
- ルートセキュリティアプリケーションに保護されていない機密文書を送信する
- ログセキュリティ監査結果をコンプライアンス報告のために記録する
ビジネス上のメリット:
- 機密情報のセキュリティコンプライアンスを確保します PDF 文書
- 保護されていない機密文書を100%自動的に検出します
- セキュリティ対策が施されていない文書の配布によるデータ漏洩を防止します。
- コンプライアンスのための包括的なセキュリティ監査証跡を維持する
メタデータに基づく自動ルーティングワークフロー
抽出された情報に基づくインテリジェントなルーティングでドキュメント自動化を強化します。 PDF メタデータとプロパティ:
ワークフローの手順を完了する:
- トリガー: PDF ドキュメントはどのソースからでも処理キューに入ります
- 抽出する著者、主題、技術的特性を含むすべてのメタデータを取得します。
- 分析ページ数、ファイルサイズ、およびコンプライアンス状況を確認する
- ルートメタデータに基づいてドキュメントをワークフローに直接振り分ける:
- 大きい: 10MBを超えるファイル → 圧縮ワークフロー
- 暗号化: 保護されたファイル → 処理のためにワークフローのロックを解除
- 複数ページ: 100ページを超える文書 → ワークフローを分割する
- 追跡メタデータ分析に基づくログルーティングの決定
ビジネス上のメリット:
- メタデータ駆動型ロジックによるインテリジェントな条件付きルーティングを可能にする
- 適切なワークフローに自動的にルーティングすることで処理を最適化します
- 自動ルーティングにより、手作業による文書選別を100%削減します。
- メタデータに基づくインテリジェンスで多様な文書タイプを処理します
業界におけるユースケースとアプリケーション
- Document Management
- Compliance & Regulatory
- Legal & Professional Services
- Publishing & Content Management
- 図書館目録作成: ドキュメントライブラリのメタデータを抽出します
- 検索機能の強化検索性を向上させるためのインデックスメタデータ
- 品質管理文書のプロパティとコンプライアンスを検証する
- 在庫管理メタデータを使用してドキュメントコレクションを追跡する
- コンプライアンス検証PDF/Aおよびセキュリティ準拠を確認する
- 監査準備監査文書用のメタデータを抽出する
- 顧客維持管理: 保持ポリシーの作成日を追跡する
- セキュリティ監査暗号化と署名の状態を識別する
- 文書追跡: 事件ファイル管理のためのメタデータを抽出する
- バージョン管理変更日とバージョンを追跡する
- 著者の帰属: 文書作成者記録を維持する
- 電子情報開示法的保留および証拠開示のためのメタデータの抽出
- 著作権追跡著者および著作権情報を抽出します
- バージョン管理文書のバージョンと変更履歴を追跡する
- 品質保証技術仕様を検証する
- コンテンツの構成メタデータ属性に基づいてコンテンツを整理する