スプリット PDF テキストによる Zapier
このアクションが何をするか
この操作の内容: の PDF4me スプリット PDF テキストによる アクションスキャン PDF 定義した特定のテキストフレーズ(セクションヘッダー、展示ラベル、フォーム区切り文字、または任意の固有文字列)ごとにドキュメントを分割します。分割するかどうかを選択してください。 前に そのフレーズ、 後 それ、または 区切りページを削除する 完全に。出力は ZIP ファイル 個々の分割すべてを含む PDFダウンロード、アーカイブ、配布の準備ができました。バーコード印刷や手動分割は不要です。ドキュメント内の既存のテキストマーカーは、自動的に分割ポイントになります。 Zapier ワークフロー。
認証 API リクエスト
毎 PDF4me アクション Zapier 有効な API キー。接続 PDF4me 一度 Zapierアカウント設定 - キーは安全に保管され、すべてのアカウントで再利用されます PDF4me 自動的に駆除します。
見逃してはならない重要な事実
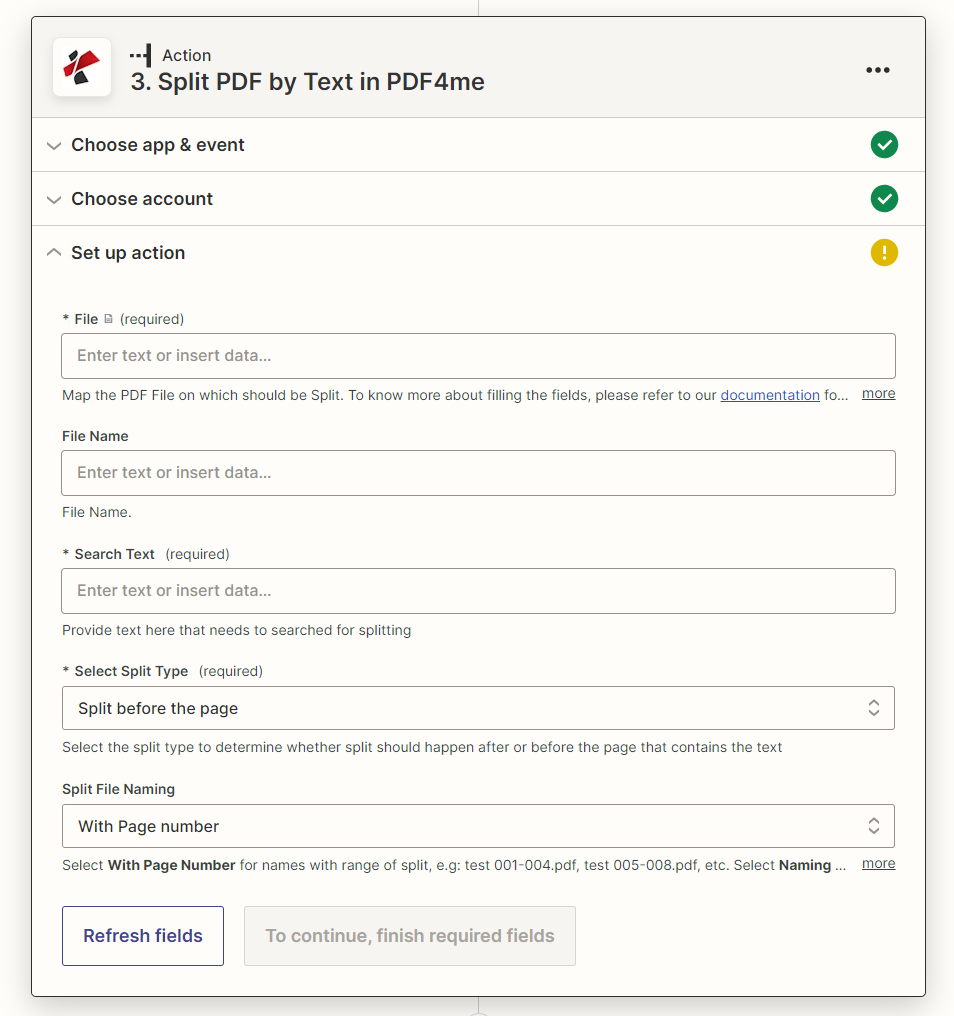
パラメータ
⚠️ ファイル、テキスト分割、タイプ分割はすべて必須です。 いずれか一つでも欠けていると、処理が失敗します。ファイル名は省略可能です。省略した場合、出力名はソースファイルから生成されます。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| File | Optional | The PDF to split. Map the binary file output from a Zapier trigger or previous action - Google Drive file, Gmail attachment, OneDrive/Dropbox file, or a PDF generated by an earlier step. A direct URL to a PDF can also be passed. | consolidated_report_may2026.pdf |
| File Name | Optional | Custom name for the output ZIP file. If omitted, the name is derived automatically from the source File field. Do not include a path - just the base filename without extension. | split_contracts_may2026 |
| Split Text | Yes | The exact text phrase to search for as the split marker. Must match verbatim - including casing, spaces, and punctuation - as it appears in the PDF. Use a phrase unique to each section boundary to avoid false matches. | EXHIBIT A |
| Split Type | Yes | Controls where the document is cut relative to the page containing the text. "Before the Text" - the split occurs before the separator page (separator becomes first page of the next document). "After the Text" - split occurs after the separator page (separator stays at the end of the current document). "Remove the page containing the Text" - the separator page is discarded and not included in any output document. | Remove the page containing the Text |
| File URL (Either provide File or File URL) | Optional | Link to the PDF to split, as an alternative to File. Map a file URL from a previous step. | |
| Search Text | Required | Text to search for; the PDF is split at each page that contains it. The app's example is the pattern `invoicenr(.*)`. | |
| Select Split Type | Required | Whether the PDF is split before or after the page that contains the text. Defaults to Split before the page. | Split before the page |
| Split File Naming | Optional | How the split files are named. **With Page number**: each name carries the page range of the part, for example `test 001-004.pdf`, `test 005-008.pdf`. **Naming as per order**: each name carries the sequence number of the part, for example `test 1.pdf`, `test 2.pdf`. Defaults to With Page number. | With Page number |
出力フィールド
| 出力フィールド | 説明 |
|---|---|
File | URL of the ZIP file containing all split PDF documents - download or upload this to a storage service in the next step |
File Name | ZIP filename without the extension |
Full File Name | Complete ZIP filename including the .zip extension |
File Extension | Always .zip - the output package format for split documents |
出力
このアクションは、分割ファイルごとに1行の項目とジョブ識別子を返します。後続のZapステップで、動的フィールドリストからそれらを選択してください。
| 分野 | タイプ | 内容物 |
|---|---|---|
| ジョブID | 文章 | ID PDF4me リクエストを処理したジョブ。 |
| トレースID | 文章 | リクエストのトレースID、 PDF4me 1を返します。 PDF4me 問題を報告する際のサポート。 |
| ドキュメント[]ドキュメントID | 文章 | ID PDF4me 分割されたファイルごとに、結果として得られる各ドキュメント(1行の項目)が提供されます。 |
| ドキュメント[]ファイル名 | 文章 | 各分割ファイルの名前(拡張子なし)。 |
| ドキュメント[]ファイル拡張子 | 文章 | 分割された各ファイルの拡張子、例えば .pdf。 |
| ドキュメント[]フルファイル名 | 文章 | 各分割ファイルの名前(拡張子を含む)。 |
| ドキュメント[]ファイルURL | 文章 | 各分割ファイルのダウンロードリンク。後続の手順で各ファイルを処理するために、このリンクをマッピングしてください。 |
| ドキュメント[]ファイル代替URL | 文章 | 各分割ファイルの代替ダウンロードリンク、ファイル名は末尾にあります URL。 |
| ドキュメント[]ファイルサイズ | 番号 | 各分割ファイルのサイズは、以下によって報告されます。 PDF4me。 |
| ファイルから読み取ったテキスト | 文章 | 各分割ファイルに含まれるテキスト。(Zapier (ファイルから読み込んだテキストとラベル付けします。) |
PDF4me リクエストをバックグラウンドジョブとして処理し、 Zapier 次のステップを実行する前に、結果を待ちます。
クイックセットアップ
- Zapを作成または開く マルチセクションを提供するトリガーを追加します PDF - Google Drive の新規ファイル、Gmail の添付ファイル、OneDrive、Dropbox、またはドキュメントを生成する以前の Zap ステップ。
- アクションステップを追加する → 検索 PDF4me →選択 スプリット PDF テキストによる。
- 認証する あなたの PDF4me API まだ接続されていない場合は、キーを入力してください。
- マップファイル トリガー出力(バイナリファイルフィールドまたは PDF URL)
- 分割テキストを入力 - あなたの PDF (例えば。
EXHIBIT A、DEPARTMENT:、NEW FORM) - 分割タイプを選択 文書の構造に応じて、区切りページの前、後、または削除を選択します。
- ファイル名を任意で設定します 出力について ZIPソースファイルから自動的に名前を取得する場合は、空欄のままにしてください。
- ステップをテストする - Zapier サンプルを処理します PDF そして返します ZIP URL ファイル出力において。
- 下流ステップを追加する - アップロード ZIP Google Drive または Dropbox に保存したり、メールや Slack でダウンロード リンクを送信したり、サブ Zap をトリガーして各抽出ファイルを処理したりできます。 PDF。
ワークフローの例
ワークフローの例Common Zapier patterns using Split PDF by Text.
統合された月次レポートを各部門のヘッダーごとに分割し、関連するセクションを各部門の責任者に自動的にメールで送信します。
- Googleドライブ:フォルダに新しいファイルが追加されました - 統合されたレポートについては「月次レポート」フォルダをご覧ください PDF
- PDF4me: スプリット PDF テキストによる分割 - マップファイル; テキスト分割 = '部門:'; 分割タイプ = テキストの前; ファイル名 = 'report_sections'
- Googleドライブ:ファイルのアップロード - 出力の保存 ZIP 「レポート、分割」フォルダへ
- Gmail: メールを送信 - 添付 ZIP URL レポートコーディネーターに通知し、サブZapが各セクションを適切な部門リーダーにルーティングします。
署名済みの契約書 PDF 添付資料の表紙が同梱されている場合は、それを本契約書と個々の添付資料に分割し、表紙は破棄してください。
- Gmail: 新しい添付ファイル - 件名に「契約締結済み」を含むメールをフィルタリングする
- PDF4me: スプリット PDF テキスト - マップファイル(添付ファイル)による分割; テキスト分割 = 'EXHIBIT'; 分割タイプ = テキストを含むページを削除
- Google ドライブ: ファイルのアップロード - 保存 ZIP 日付順に整理された「契約書、分割」フォルダへ
- Slack: #legal にメッセージを投稿してください。契約名とドライブリンクをチームに通知し、弁護士が割り当てられた証拠資料を取得できるようにします。
バッチ印刷されたフォームを単一の PDF 各フォームの最初のページにテキストマーカーを使用して、個別のファイルに分割します。
- Dropbox: フォルダ内の新しいファイル - 一括フォームが保存される「バッチスキャン」フォルダを監視してください PDFsは削除されます
- PDF4me: スプリット PDF テキストによる分割 - マップファイル; テキスト分割 = 'FORM ID:'; 分割タイプ = テキストの後(フォームID行が各フォームに残って識別できるようにするため)
- Dropbox: ファイルのアップロード - 分割を保存 ZIP 「フォーム、個人」フォルダへ
- Zapier Webhook またはコードステップ: ファイル名を解析します ZIP フォームIDを抽出し、Airtable、Salesforce、またはカスタムデータベース内の下流キューをトリガーする