行を抽出する Excel - JSON エクスポート対象 Zapier
PDF4me 行を抽出する は Zapier 範囲を変換するアクション Excel 行と列を構造化 JSONワークシートと行/列の範囲を設定するか、すべてを抽出するか、値をネイティブ型のままにするかテキストとしてエクスポートするかを選択します。抽出された行のダウンロードリンクが返され、 APIs、データベース、または次のZapステップ。
このアクションが何をするか
ワークシートを読み込む Excel 前の Zap ステップでマッピングされたファイルに対して、設定した行/列範囲とフィルタリング オプションを適用し、各行が JSON オブジェクト。Has Header Row を使用して、各オブジェクトのキーを最初の行の後に名前を付け、Exclude オプションで非表示または空の行をスキップし、数値と日付をネイティブのままにするかどうかを選択します。 JSON 入力するか、プレーンテキストとしてエクスポートします。
認証 API リクエスト
アクセスするには PDF4me ウェブ API を通して Zapierすべてのリクエストには適切な認証情報を含める必要があります。認証により安全な通信が保証され、承認されたユーザーとしての身元が検証され、シームレスな統合が可能になります。 Zapier ワークフローと PDF4meの強力な Excel データ抽出サービス。
見逃してはならない重要な事実
:::ヒント:前の手順でマップファイルとファイル名を取得してください + 隣のボタン ファイル そして ファイル名 以前の Zap ステップからマッピングするには、たとえば、 ファイル名全体 以前の PDF4me Excel 行動。 Excelファイルには完全なコンテンツを提供する必要があり、「存在するが表示されない」参照は認められません。 :::
:::警告 ファイル: (存在しますが表示されません) ファイルフィールドに「ファイル: (存在しますが表示されません)」と表示され、「ファイルが空です」エラーが発生する場合は、 ファイルの内容全体 代わりに。参照 Zapier & Power Automate ヒント詳細は :::
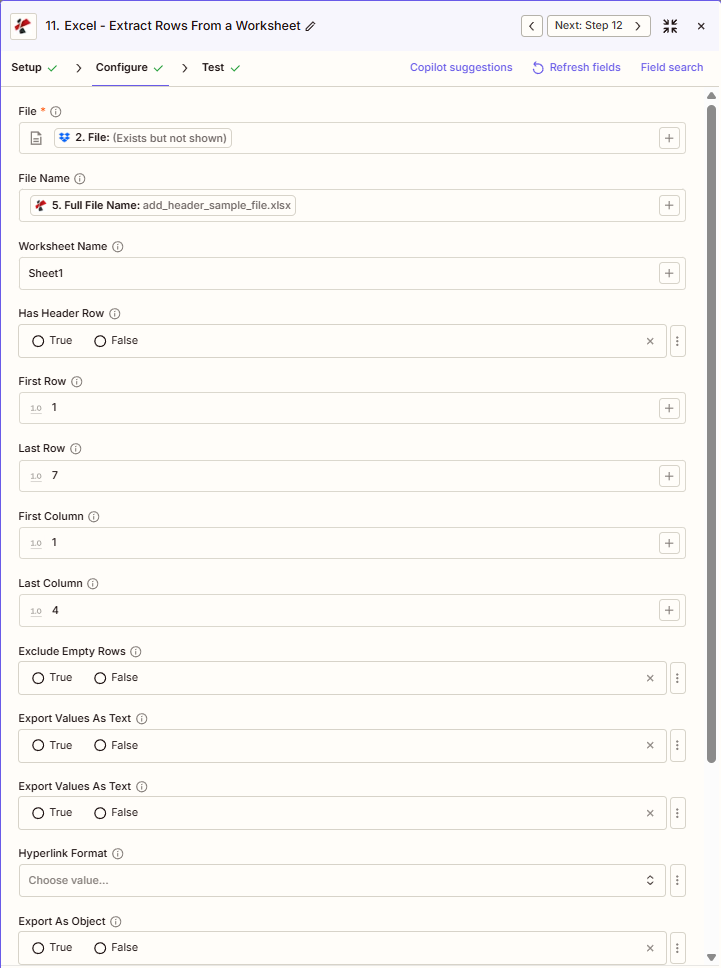
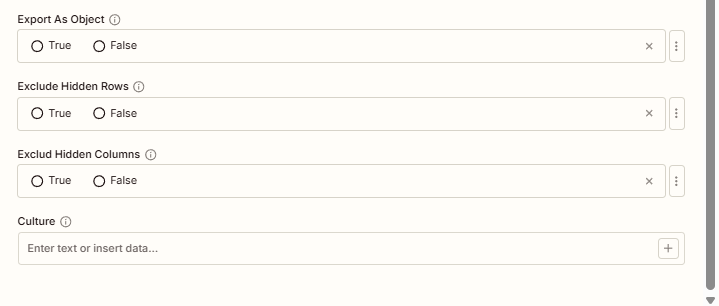
行抽出の主な機能は何ですか?
- JSON 出力: 抽出する Excel 構造化されたデータ JSONファイルとして返されます
- 柔軟な範囲: 最初/最後の行と最初/最後の列を指定します Excel独自の1ベースの数字
- ヘッダー行のサポート: ヘッダー行は最初の行を JSON キー
- フィルタリング: 非表示の行、非表示の列、空の行を除外する
- データ型制御: 値をテキストとしてエクスポートして、すべてのテキストを出力します
- オブジェクトとしてエクスポート: 構造出力として JSON オブジェクトまたは配列
パラメータ
行抽出アクションのパラメーターの完全なリスト。パラメーター名は、 Zapier 構成 UI 上記のスクリーンショットに示されています。
- 地図 ファイル (Excelトリガーまたは前のステップから
- オプションでマッピング ファイル名 そして設定する ワークシート名 (例:シート1)
- セット 最前列、 最後列、 最初の列、 最後の列 (1から始まる;-1=終了)
- セット ヘッダー行があります、 オブジェクトとしてエクスポート必要に応じてその他のオプションも
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| File | Optional | Excel file to extract rows from. Map from a previous step. Must provide full file content. | [2. File from Step 2] |
| File Name | Optional | Excel filename, used for output file identification. | add_header_sample_file.xlsx |
| Worksheet Name | Optional | Target worksheet to extract from. Empty extracts from the first worksheet. | Sheet1 |
| Has Header Row | Optional | True uses the first row in the range as JSON property names. | True |
| First Row | Optional | Starting row, 1-based. 1 = Excel row 1. | 1 |
| Last Row | Optional | Ending row, 1-based. -1 = last row with data. | 7 |
| First Column | Optional | Starting column, 1-based. 1 = column A. | 1 |
| Last Column | Optional | Ending column, 1-based. -1 = last column with data. | 4 |
| Exclude Empty Rows | Optional | True skips rows with no data. | False |
| Export Values As Text | Optional | True exports every value as a string; False preserves native types. | False |
| Hyperlink Format | Optional | How to represent cell hyperlinks in the output. | - |
| Export As Object | Optional | Controls whether the output is structured as a JSON object or array. | True |
| Exclude Hidden Rows | Optional | True skips rows hidden in the worksheet. | False |
| Exclude Hidden Columns | Conditional | True skips columns hidden in the worksheet. Zapier labels this field "Exclud Hidden Columns". | False |
| Culture | Optional | Locale for date/number formatting. | en-US |
| File URL (Either provide a File or File URL) | Optional | Link to the Excel workbook to extract the rows from, as an alternative to File. Map a file URL from a previous step. | |
| Exclud Hidden Columns | Optional | Skip hidden columns in extraction | |
重要: のみ ファイル が必要です。 + 各フィールドの横にあるボタンを使用してデータをマッピングします。最初の行/最後の行と最初の列/最後の列を使用します Excel自身の 1ベース 番号付け(1行目、A列目=1)であり、ゼロベースのインデックスではありません。
行抽出機能は何が返されますか?
の PDF4me 行を抽出する Excel アクションは包括的な結果を返します JSON シームレスな出力データ Zapier ワークフロー統合。
| 分野 | タイプ | 内容物 |
|---|---|---|
jobId | Text | ID of the PDF4me job that processed the request. |
traceId | Text | Trace ID of the request, when PDF4me returns one. Give it to PDF4me support when reporting a problem. |
documentId | Text | ID PDF4me gives the resulting document. |
File Name | Text | Name of the resulting file, without extension. |
File Extension | Text | Extension of the resulting file, for example `.pdf`. |
Full File Name | Text | Name of the resulting file, with extension. |
File Url | Text | Download link of the file with the extracted rows. Map it into any later step that needs the data. |
Alternate File Url | Text | Alternative download link of the resulting file, with the file name at the end of the URL. |
File Size | Number | Size of the resulting file, as reported by PDF4me. |
- JSON
- Zap Integration
例 JSON 応答:
{
"jobId": "9f1c2e7a-4b7d-4f2a-8c31-0d5b6e9a1f44",
"traceId": "4b7d2e18-9c3a-4f55-b0e2-7a1d8c6f3b02",
"documentId": "07386627-184a-44b2-a040-5ea2712a4bc5",
"File Name": "extracted_rows",
"File Extension": ".json",
"Full File Name": "extracted_rows.json",
"File Url": "https://api.pdf4me.com/Zapier/GetDocument/...",
"Alternate File Url": "https://api.pdf4me.com/Zapier/GetAltDocument/.../extracted_rows.json",
"File Size": 3072
}
ファイルURLにあるファイルの内容:
[
{"Name": "John Doe", "Age": 30, "Salary": 50000.50},
{"Name": "Jane Smith", "Age": 28, "Salary": 55000.00}
]
走るとき テストアクション Zapエディタでは、 Zapier 生の PDF4me 回答 結果 これらのファイルフィールドの代わりに。
使用 + 地図を作成する ファイルURL 次のステップに進み、ループステップ、データベース書き込み、または直接ダウンロードしたファイルから行を読み取ります。 API 電話。
典型的な構成
ワークフローの例Common Zapier workflow patterns using Extract Rows.
- スケジュールされたトリガーは、一定の間隔で実行されます。
- PDF4me 行の抽出は、ファイルとファイル名をマッピングし、「ヘッダー行を持つ」をTrueに設定し、「値をテキストとしてエクスポート」をFalseに設定して、ネイティブの数値型と日付型を保持します。
- ダウンロードステップではファイルURLを取得し、ループステップでは各行オブジェクトをPOSTします。 REST API 終点。
- 新しい Excel ファイルはストレージフォルダにアップロードされます。
- PDF4me 「行の抽出」では、タイトル行をスキップするために「最初の行」を2に設定し、残りのデータについては「最後の行」を-1に設定し、「空の行を除外」をTrueに設定します。
- データベースステップでは、ダウンロードしたファイルから行を一括挿入します。 SQL テーブル。
- 日次トリガーは、下流の処理ジョブの前に実行されます。
- PDF4me 「行の抽出」では、「値をテキストとしてエクスポート」が「True」に設定されているため、日付や数値を含むすべての値が、パターンチェック用のプレーンな文字列として取得されます。
- フィルターまたはコードステップによって、データ処理が続行される前に、各行のテキストが想定される形式と照合されます。
実践的なヒント
チートシート
| 分野 | 価値 |
|---|---|
| Action | Extract Rows |
| File | [Mapped from previous step] |
| Worksheet Name | Sheet1 |
| First Row / Last Row | 1 / 7 (1-based, -1 = to end) |
| First Column / Last Column | 1 / 4 (1-based, -1 = to end) |
| Has Header Row | True |
| Export Values As Text | False (preserve types) |
よくある質問
関連アクション
他のプラットフォームでの同じタスク
業界におけるユースケースとアプリケーション
- IT & Integration
- Finance & Accounting
- Sales & Marketing
- Operations
- APIデータフィードExcelの行をJSONとして抽出し、スケジュールに従ってREST APIにPOSTしてシステム統合を行う。
- ETLパイプライン: データ型と変換を保持したまま、Excelデータをデータウェアハウスにロードする
- システム移行: レガシーExcelデータをJSONに抽出して、最新のクラウドシステムに移行する。
- データ同期Excelマスターデータを抽出して複数の下流システムに同期する
- ログ分析: 監視のために、Excelから分析プラットフォームへ運用ログを抽出する。
- トランザクションのインポート: 照合およびロードのために、Excelエクスポートからトランザクション行を抽出します。
- GL勘定科目の読み込みExcelテンプレートから会計システムに勘定科目表を抽出する
- 予算データ統合BIツール用に数値型を保持したまま予算行を抽出する
- 経費精算処理従業員の経費明細をJSON形式で抽出し、承認ワークフローに利用する。
- 財務諸表のエクスポート連結システム用に損益計算書と貸借対照表の行を抽出する
- キャンペーンデータのエクスポートキャンペーンパフォーマンスの行を分析およびアトリビューションプラットフォームに抽出する
- リードリスト統合API を介して Excel インポートからリード行を抽出して CRM システムへ取り込む
- 販売パイプラインのエクスポート外部予測ツール向けに機会データをJSON形式で抽出する
- 顧客データインポートマーケティングオートメーション用に、データ型を保持したまま顧客行を抽出する
- 製品カタログの読み込みExcelからeコマースシステムに商品行を抽出する
- 在庫データ抽出: 倉庫管理システム用にExcelから在庫レベルの行を抽出する
- 生産ログのエクスポート: 製造分析のために生産実行データをJSON形式で抽出する
- 品質データ統合: 品質管理プラットフォーム向けにQC検査行を抽出します
- 機器データロードExcelからCMMSおよびEAMシステムに資産行を抽出する
- 物流データのエクスポートTMS統合のために、日付と番号を含む出荷行を抽出する。