テキストと画像を抽出 Power Automate
PDF4me テキストと画像を抽出 アクションは、すべてのテキストコンテンツと埋め込み画像を取得します。 PDF ドキュメント Power Automate 包括的なコンテンツ抽出のために。この多機能な機能は、テキストと画像の抽出を個別に制御し、全文を文字列として、画像をオブジェクトの配列として返します。これにより、コンテンツの再利用、データ分析、画像処理、およびマルチフォーマットのコンテンツ配信が可能になります。 Microsoft 365 ワークフロー。
認証 API リクエスト
アクセスするには PDF4me ウェブ API を通して Power Automateすべてのリクエストには適切な認証情報を含める必要があります。認証により安全な通信が保証され、承認されたユーザーとしての身元が検証され、シームレスな統合が可能になります。 Power Automate 流れと PDF4meの強力なコンテンツ抽出サービス。
主な機能
- テキスト抽出: すべてのテキストコンテンツを取得します PDF 文書
- 画像抽出: 埋め込まれた画像をすべて個別のファイルとして抽出します。
- 独立制御テキストのみ、画像のみ、または両方を抽出するかを選択してください。
- Array 出力画像を配列として受け取り、反復処理を行います。
- バッチ処理: 複数のソースからコンテンツを抽出 PDFワークフロー内のs
パラメータ
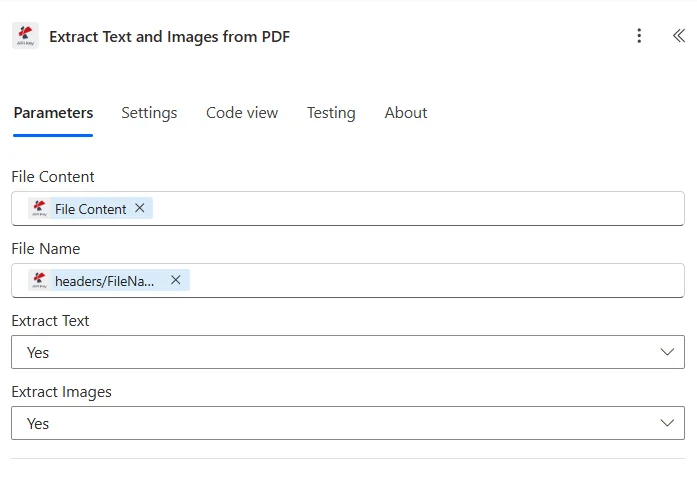
テキストと画像の抽出アクションのパラメータ一覧です。これらのパラメータを設定することで、コンテンツの抽出を制御できます。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| File Content | Required | Content of the PDF to extract text and images from. Map it from the file content returned by a previous action, such as SharePoint or OneDrive Get file content. | @{body('Get_file_content')?['$content']} |
| File Name | Required | Name of the PDF to extract text and images from, including its extension (for example `invoice.pdf`). Map it from the file name returned by a previous action. | invoice.pdf |
| Extract Text | Optional | If Yes, the text of the PDF is extracted and returned in texts. Defaults to `Yes`. | Yes |
| Extract Images | Optional | If Yes, the images in the PDF are extracted and returned in images. Defaults to `Yes`. | Yes |
出力
の PDF4me テキストと画像を抽出 アクションは、シームレスな包括的な出力データを返します Power Automate フロー統合:
- Table
- JSON
- Flow Integration
テーブルビュー
構造化された表形式の応答データ:
| 分野 | タイプ | 内容物 |
|---|---|---|
| texts | Array | Extracted text, as a list with one item (Page Text) per page. |
| images | Array | Extracted images. Use an Apply to each over this list to save each image. |
| images[].File Name | Text | File name of the extracted image. |
| images[].File Content | File content | Content of the extracted image. Map it into the next action, for example the File Content field of Create file. |
JSON 回答形式
{
  "texts": "Extracted text content from entire PDF document...",
  "images": [
    {
      "ImageData": "<file content>",
      "ImageName": "image_1.png"
    },
    {
      "ImageData": "<file content>",
      "ImageName": "image_2.png"
    }
  ]
}
Power Automate フロー使用状況
抽出したコンテンツを後続の操作で使用する:
- テキスト分析抽出したテキストをAI Builderで分析する
- 画像処理抽出した画像を個別に処理する
- データベースストレージテキストと画像をデータベースに保存する
- コンテンツの再利用抽出したコンテンツを新しいドキュメントで再利用する
- 検索インデックス作成検索可能なように抽出したテキストをインデックス化します
- 別々にアーカイブするテキストと画像を整理された構造で保存する
ワークフローの例
の PDF4me テキストと画像を抽出 アクション Power Automate 実際のビジネスシナリオに合わせて設計された包括的なワークフローテンプレートを提供します。
- Content Archival
- Content Analysis
- Content Migration
- Translation Preparation
自動コンテンツ分離およびアーカイブ
自動抽出と自動保存でコンテンツ管理を変革しましょう。
ワークフローの手順を完了する:
- トリガー: ドキュメントが処理フォルダにアップロードされました
- ドキュメントを取得する: 取得 PDF から SharePoint
- コンテンツを抽出テキストと画像の両方を抽出する
- テキストを保存抽出したテキストをアーカイブ内のテキストファイルに保存する
- 各画像に適用する抽出した画像を反復処理する
- 画像を保存する各画像を画像フォルダに個別に保存します。
- インデックスを作成するテキストと画像参照を含むメタデータを生成する
- データベースの更新: ログ抽出の詳細と場所
ビジネス上のメリット:
- 200以上のコンテンツを分離します PDF毎月
- テキストと画像の独立した管理を可能にする
- ストレージの冗長性を60%削減します
- コンテンツの再利用と再活用を促進する
自動化 PDF コンテンツ分析ワークフロー
テキストと画像の自動抽出でコンテンツ分析を効率化:
ワークフローの手順を完了する:
- トリガー研究論文 PDF 分析のためにアップロードされました
- 得る PDF: 取得 PDF 研究図書館より
- テキストを抽出: すべてのテキストコンテンツを取得します
- テキスト分析感情分析とキーワード分析にはAI Builderを使用してください。
- 画像を抽出する: 埋め込まれたすべての画像とグラフを取得します
- プロセスイメージAIビジョンを使用して画像を分析します
- レポートの作成分析結果をまとめたレポートを作成する
- メールリサーチャー分析概要を送信
ビジネス上のメリット:
- 毎月50件以上の研究文書を分析する
- 包括的なコンテンツ分析を自動化します
- 分析時間を4時間から20分に短縮
- AI を活用した洞察を可能にする PDF コンテンツ
自動コンテンツ移行 SharePoint
自動抽出とインポートでコンテンツ移行を最適化:
ワークフローの手順を完了する:
- トリガー: 遺産 PDF 移行のためにアップロードされました
- 得る PDF: 取得 PDF 移行元から
- テキストを抽出: インデックス作成のためにすべてのテキストコンテンツを取得します
- 画像を抽出する: 埋め込まれたすべての画像を取得します
- 作成する SharePoint ページ: モダンな建物を建てる SharePoint ページ
- テキストコンテンツを追加する抽出したテキストをページにインポートする
- 画像をアップロードする画像を追加する SharePoint 資産
- リンクコンテンツページコンテンツ内の参照画像
ビジネス上のメリット:
- 100以上のレガシーシステムを移行 PDF月刊から現代形式へ
- コンテンツの検索と発見を可能にする SharePoint
- 手動移行時間を85%削減
- コンテンツのアクセシビリティとユーザビリティを維持する
翻訳のための自動コンテンツ抽出
自動コンテンツ抽出機能で翻訳ワークフローを強化:
ワークフローの手順を完了する:
- トリガー: 翻訳対象文書
- ドキュメントを取得する: 取得 PDF 翻訳が必要
- テキストを抽出: すべてのテキストコンテンツを取得します
- 画像を抽出する埋め込み画像を個別に取得する
- 翻訳者へ送信: テキストを Azure Translator に送信 API
- テキストを翻訳する: テキストをターゲット言語に変換する
- ドキュメントの再作成: 新規構築 PDF 翻訳されたテキストとオリジナルの画像付き
- 関係者へのメール送信翻訳済み文書を送信
ビジネス上のメリット:
- 毎月40件以上の文書を翻訳
- テキストを翻訳しながら元の画像を保持します
- 翻訳準備時間を75%短縮します
- 多言語文書の迅速な作成を可能にする
業界におけるユースケースとアプリケーション
- Publishing & Media
- Legal & Professional Services
- Marketing & Communications
- Education & Training
出版・メディアにおける活用事例
- コンテンツ抽出: コンテンツの再利用のためにテキストと画像を抽出します。
- デジタルアセット管理文書資産を分離してカタログ化する
- コンテンツ移行プラットフォーム移行用のコンテンツを抽出します。
- アーカイブ管理コンテンツを個別に整理してアクセスしやすくする
法律・専門サービスにおけるユースケース
- 文書レビュー法的審査および分析のためにテキストを抽出します。
- 証拠収集: 事件文書から画像とテキストを抽出する
- 発見処理電子情報開示用の別コンテンツ
- コンテンツ分析: コンプライアンスおよびレビューのための抜粋
マーケティングおよびコミュニケーションにおける活用事例
- コンテンツの再利用マーケティング目的で再利用するためのコンテンツ抽出
- 資産回収マーケティングライブラリ用の画像を収集する
- キャンペーン資料キャンペーン作成用のコンテンツを抽出します。
- ブランド資産管理ロゴやブランドイメージを収集する
教育・研修における活用事例
- コースコンテンツ抽出コース教材からテキストと画像を抽出する
- 学習オブジェクトの作成LMSアップロード用の別コンテンツ
- コンテンツ移行プラットフォーム移行のための抽出
- アーカイブ管理教育コンテンツ資産を整理する