Word文書を分割する n8n アクション
PDF4me 分割されたワード文書 Word文書を複数の小さな文書に分割することを可能にする n8n 柔軟な分割オプションと包括的な構成制御を備えた自動化ワークフロー。この強力なドキュメント分割機能は、ページ単位の分割、セクション単位の分割、見出し単位の分割、カスタムページ範囲をサポートし、分割基準、ドキュメント命名規則、出力構成を完全に制御できるため、ドキュメント管理、コンテンツ配信、ワークフロー自動化に最適です。
関連ブログ記事
この機能に関するブログ記事はまだありません。近日公開予定です。
その間、PDF4me ブログを閲覧して、あらゆるプラットフォームのチュートリアルやワークフローをご覧ください。
ブログをご覧ください →
設定
追加する PDF4me 「Word文書を分割」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「Word文書を分割」アクションを選択します。
- 入力パラメータを設定します(下記参照)。
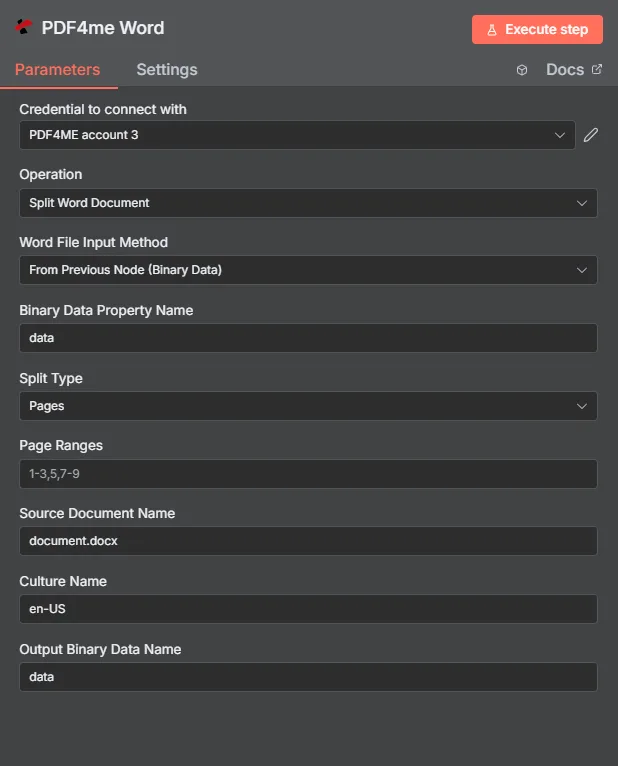
パラメータ
Word文書分割アクションのパラメータ一覧です。これらのパラメータを設定することで、文書分割の動作を制御できます。
重要: アスタリスク(***)が付いているパラメータは必須です。詳細パラメータを使用すると、分割基準と文書処理をきめ細かく制御できます。
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| 入力データ型*** | String | ワード文書の入力形式選択 • Word文書のデータ入力形式を選択してください • PDF4me 複数の入力タイプをサポートしています • オプション: バイナリデータ、 Base64 文字列、または URL | Binary Data |
| 入力バイナリフィールド*** | バイナリ | バイナリワードファイル入力 (バイナリデータの場合必須) • 前のファイル(.docx、.doc)を参照 n8n ノードまたはファイルのアップロード • PDF4me バイナリ Word ファイルを自動フォーマット検出で処理します ・入力データタイプが「バイナリデータ」の場合に必須 | {{ $binary.data }} |
| Base64ワードコンテンツ*** | String | Base64 エンコードされた単語入力 (Base64文字列の場合に必須) • 安全な送信のために、Word コンテンツ (.docx、.doc) を base64 エンコードされた文字列として提供します。 • PDF4me Wordコンテンツを自動的にデコードして処理します • 入力データ型が「Base64文字列」の場合に必須です。 | UEsDBBQABgAI... |
| Word文書のURL*** | String | 公開ワード文書 URL 入力 (URLの場合は必須) • 公開/オープンな許可を提供する URL 処理対象のWordファイル(.docx、.doc) • PDF4me 提供されたWordファイルをダウンロードして処理します URL ・入力データタイプが「URL」の場合に必須です。 | https://abc.com/document.docx |
| Word文書名*** | String | Word文書の入力ファイル名 ・入力するWordファイルの名前を適切な拡張子(.docx、.doc)で指定してください。 • PDF4me フォーマット検出と処理最適化にこれを使用します | document.docx |
| 分割タイプ | String | 文書分割の種類 • allpages - 個別のページに分割(デフォルト) • 配列 - ページ範囲に基づいて分割します(例:「1-3、4、5-7」) • numberofpages - ページ範囲に基づいて分割します(「array」と同じ) • セクション - ドキュメントのセクションごとに分割 • 見出し - 見出しスタイルごとに分割(例:「見出し1」) | "allpages" |
| 分割設定 | String | 分割設定 • ページ範囲:「1-3、4、5-7」(1~3ページ、4ページ、5~7ページ) • 単ページ:「1、3、5」(1ページ目、3ページ目、5ページ目) ・見出しスタイル:「見出し1」または「見出し2」 • 分割タイプが「array」、「numberofpages」、または「headings」の場合に必須です。 | "1-3,4,5-7" |
| 文化名 | String | 文書文化/地域 • 文書処理の文化コード (例: "en-US"、"de-DE"、"fr-FR") • デフォルト: "en-US" ・文書の言語と書式に影響します | en-US |
出力
出力パラメータ
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| ファイル名 | String | 分割されたドキュメントファイル名 - 分割された出力Word文書ファイルの名前 | document_part1.docx |
| ファイルサイズ | 番号 | ファイルサイズ(バイト単位) 分割されたWord文書のサイズ(バイト単位) | 13398 |
| 部品番号 | 番号 | 部品番号 - この分割部分の連番(1から始まる) | 1 |
| 合計部品数 | 番号 | 部品の総数 - 元の文書から作成された分割部分の総数 | 1 |
| 成功 | Boolean | PDF4me 動作状況 - Boolean 文書分割操作の成否を示すフラグ。 PDF4me リターン true 業務の成功と false エラーが発生した場合 | true |
| オリジナルファイル名 | String | 元のWord文書ファイル名 - 入力するWord文書ファイルの名前 | document.docx |
| 分割タイプ | String | 分割タイプを使用 - 適用された分割の種類(例:「ページ」、「セクション」、「見出し」) | Pages |
| ページ範囲 | String | ページ範囲 - 分割に使用されたページ範囲(例:「1,2,3」または「1-3,4,5-7」) | 1,2,3 |
| カルチャー名 | String | 文書文化/地域 - 文書処理に使用されるカルチャコード(例:「en-US」、「de-DE」、「fr-FR」) | en-US |
| メッセージ | String | 作戦メッセージ 分割操作の結果を示す説明メッセージ(部品情報を含む) | Split document part 1 of 1 |
N8N 行動対応
の PDF4me 分割されたワード文書 API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
[
  {
    "fileName": "document_part1.docx",
    "fileSize": 13398,
    "partNumber": 1,
    "totalParts": 1,
    "success": true,
    "originalFileName": "document.docx",
    "splitType": "Pages",
    "pageRanges": "1,2,3",
    "cultureName": "en-US",
    "message": "Split document part 1 of 1"
  }
]
テーブルビュー
構造化された表形式の応答データ(最初の分割ドキュメントを表示):
| パラメータ | 価値 |
|---|---|
| fileName | document_part1.docx |
| fileSize | 13398 |
| partNumber | 1 |
| totalParts | 1 |
| success | true |
| originalFileName | document.docx |
| splitType | Pages |
| pageRanges | 1,2,3 |
| cultureName | en-US |
| message | Split document part 1 of 1 |
注:配列には複数のドキュメントが返されます。各分割セクションごとに1つのドキュメントが返されます。
スキーマビュー
レスポンスのデータ構造と型:
1 item
[0]
  fileName: T document_part1.docx
  fileSize: # 13398
  partNumber: # 1
  totalParts: # 1
  success: ☑ true
  originalFileName: T document.docx
  splitType: T Pages
  pageRanges: T 1,2,3
  cultureName: T en-US
  message: T Split document part 1 of 1
タイプ指標:
T= String (文章)#= 番号☑= Boolean[]= Array
バイナリデータビュー
実際のWord文書ファイルデータとメタデータ(分割された文書ごとに):
data
─────────────────────────────
File Name: document_part1.docx
File Extension: docx
Mime Type: application/vnd.openxmlformats-officedocument.wordprocessingml.document
File Size: 13.4 kB
バイナリデータアクセス:
- n8n バイナリオブジェクト:
$binary.data.data(分割されたドキュメントごとに) - Base64 コンテンツ直接使用可能
- ファイル操作ダウンロード、メール送信、または保存の準備ができました
- 複数のファイル分割された各セクションは、個別のバイナリアイテムとして利用可能です。
ユースケース
エンタープライズ文書自動化
- 文書管理: 大きな文書を管理しやすいセクションに分割する
- コンテンツ配信: 対象を絞った配布のためにドキュメントを分割する
- ワークフロー自動化: 文書の各セクションを個別に処理する
- アーカイブ管理文書を論理的なセクションに分割して整理する
AIを活用した文書処理
- マルチフォーマット対応.docxおよび.doc形式のWord文書を処理する
- 多言語処理: さまざまな言語と地域に対応
- インテリジェント分割: 文書構造に基づく自動分割
ビジネスインテリジェンスとアナリティクス
- 文書構成文書を適切な構造で整理する
- コンテンツ管理コンテンツを論理的な単位に分割して管理する
- パフォーマンス指標処理精度と効率を追跡する