Excel ファイルからワークシートを抽出する n8n アクション
PDF4me Excelからワークシートを抽出する Excel ブックからワークシート全体を構造化 JSON を通して n8n 自動化ワークフロー。Excel ファイルを処理する n8n トリガー、バイナリデータ、base64文字列、または公開 URLs 自動ヘッダー検出、名前またはインデックスによる柔軟なワークシート選択、複数シートのサポート、およびデータ型の保持により、ワークシートの完全なデータを抽出します。このソリューションは、完全なデータのエクスポート、複数シートの処理、 API 統合、データベース移行、包括的な Excel からJSON 構造化された出力とシームレスな統合を伴うワークシート全体の抽出を必要とする変換ワークフロー。
設定
追加する PDF4me 「ワークシートの抽出」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「Excelファイルからワークシートを抽出する」アクションを選択します。
- 入力パラメータを設定します(下記参照)。
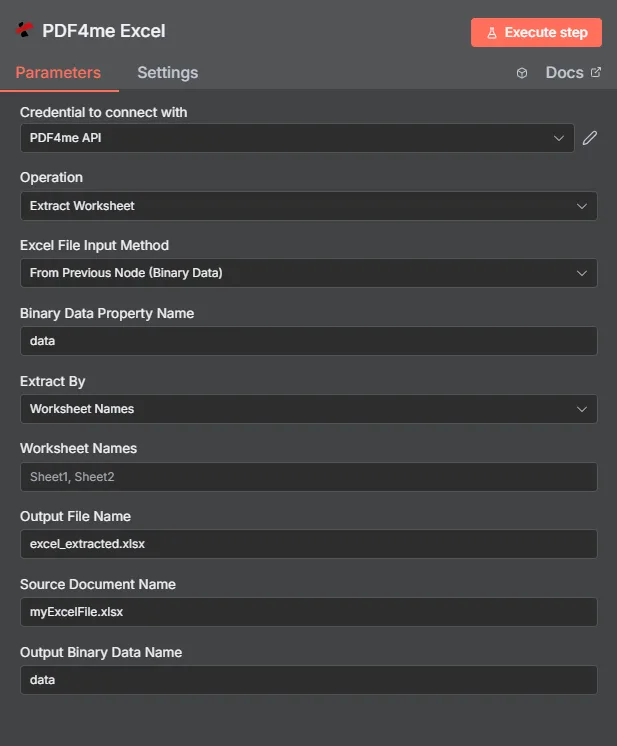
パラメータ
ワークシート抽出アクションのパラメータ一覧です。これらのパラメータを設定することで、ワークシートの抽出を制御できます。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| 入力データ型*** | String | Excelの入力形式選択 • Excelデータの入力形式を選択してください • PDF4me 複数の入力タイプをサポートしています • オプション: バイナリデータ、 Base64 文字列、または URL | Binary Data |
| 入力バイナリフィールド*** | バイナリ | バイナリExcelファイル入力 (バイナリデータの場合必須) • 前のExcelファイル(.xlsx、.xls)を参照 n8n ノードまたはファイルのアップロード • PDF4me バイナリ Excel ファイルを自動フォーマット検出で処理します ・入力データタイプが「バイナリデータ」の場合に必須 | {{ $binary.data }} |
| Base64形式のExcelコンテンツ*** | String | Base64 エンコードされたExcel入力 (Base64文字列の場合に必須) • Excelコンテンツ(.xlsx、.xls)をbase64エンコードされた文字列として提供する • PDF4me Excelコンテンツを自動的にデコードして処理します • 入力データタイプが「Base64 弦" | UEsDBBQABgAI... |
| Excel URL*** | String | パブリックExcel URL 入力 (URLの場合は必須) • 公開/オープンな許可を提供する URL Excelファイル(.xlsx、.xls)に変換 • PDF4me 提供されたExcelファイルをダウンロードして処理します URL • 入力データタイプが「URL「 | https://abc.com/data.xlsx |
| Excel名*** | String | Excel入力ファイル名 ・入力するExcelファイルの名前を適切な拡張子(.xlsx、.xls)とともに指定してください。 • PDF4me フォーマット検出と処理最適化にこれを使用します | data.xlsx |
| ワークシート名 | String | カンマ区切りのワークシート名 ・抽出するワークシート名のリスト • フォーマット: "Sheet1,Summary,Report" • 選択ロジック: 指定されている場合 → 指定されたワークシートを抽出します。WorksheetNames と WorksheetIndexes の両方が指定されている場合 → どちらか一方に一致するワークシートを抽出します (結合)。どちらも指定されていない場合 → すべてのワークシートを抽出します。 • ワークシート名の大文字と小文字を区別します | Employees,Sales |
| ワークシート索引 | String | カンマ区切りインデックス(0ベース) ・抽出するワークシートインデックスのリスト • フォーマット:「0,1,2」(インデックス0=1枚目、インデックス1=2枚目など) • 選択ロジック: 指定されている場合 → インデックス付きワークシートを抽出します。両方のパラメーターが指定されている場合 → いずれか一方に一致するワークシートを抽出します(和集合)。 • 0ベースのインデックス: インデックス 0 = 最初のワークシート | 0,2,4 |
出力
出力パラメータ
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| jsonファイル名 | String | JSON 出力ファイル名 - 生成された名前 JSON 抽出されたワークシートデータを含むファイル | excel_extracted.json |
| txtファイル名 | String | TXT出力ファイル名 抽出されたワークシートデータを含む生成されたTXTファイルの名前 | excel_extracted.txt |
| jsonファイルサイズ | 番号 | JSON ファイルサイズ(バイト単位) - サイズ JSON 出力ファイル(バイト単位) | 206933 |
| txtファイルサイズ | 番号 | TXTファイルのサイズ(バイト単位) - TXT出力ファイルのサイズ(バイト単位) | 206933 |
| 成功 | Boolean | PDF4me 動作状況 - Boolean ワークシート抽出プロセスの成功または失敗を示すフラグ。 PDF4me リターン true 業務の成功と false エラーが発生した場合 | true |
| オリジナルファイル名 | String | 元のExcelドキュメントのファイル名 - 入力Excelドキュメントファイルの名前 | myExcelFile.xlsx |
| 抽出 | String | 抽出方法 抽出対象のワークシートを識別するために使用される方法。値:「name」はワークシート名で抽出する場合、「index」はワークシートインデックスで抽出する場合。 | name |
| ワークシート名 | String | 抽出されたワークシート名 抽出されたワークシート名のカンマ区切りリスト | Sheet2 |
| 解析済みデータ | Object | 解析されたワークシートデータ - Object 抽出されたワークシートデータを含み、ワークシート名をキー、行オブジェクトの配列を値とします。各行オブジェクトには、列ヘッダーをキー、セル値を値として格納します。 | {"Sheet2": [{"First Name": "Dulce", "Age": 32}]} |
| メッセージ | String | 作戦メッセージ ワークシート抽出操作の結果を示す説明メッセージ(ワークシート名と抽出方法を含む) | Successfully extracted worksheet(s) 'Sheet2' by name and created JSON and TXT outputs |
N8N 行動対応
の PDF4me Excelファイルからワークシートを抽出する API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
[
  {
    "jsonFileName": "excel_extracted.json",
    "txtFileName": "excel_extracted.txt",
    "jsonFileSize": 206933,
    "txtFileSize": 206933,
    "success": true,
    "originalFileName": "myExcelFile.xlsx",
    "extractBy": "name",
    "worksheetNames": "Sheet2",
    "parsedData": {
      "Sheet2": [
        {
          "": 1,
          "First Name": "Dulce",
          "Last Name": "Abril",
          "Gender": "Female",
          "Country": "United States",
          "Age": 32,
          "Date": "15/10/2017",
          "Id": 1562
        },
        {
          "": 2,
          "First Name": "Mara",
          "Last Name": "Hashimoto",
          "Gender": "Female",
          "Country": "Great Britain",
          "Age": 25,
          "Date": "16/08/2016",
          "Id": 1582
        },
        {
          "": 3,
          "First Name": "Philip",
          "Last Name": "Gent",
          "Gender": "Male",
          "Country": "France",
          "Age": 36,
          "Date": "21/05/2015",
          "Id": 2587
        }
      ]
    },
    "message": "Successfully extracted worksheet(s) 'Sheet2' by name and created JSON and TXT outputs"
  }
]
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| jsonファイル名 | excel_extracted.json |
| txtファイル名 | excel_extracted.txt |
| jsonファイルサイズ | 206933 |
| txtファイルサイズ | 206933 |
| 成功 | true |
| オリジナルファイル名 | myExcelFile.xlsx |
| 抽出 | name |
| ワークシート名 | Sheet2 |
| 解析済みデータ | ワークシート名をキー、行配列を値とするオブジェクト |
| メッセージ | Successfully extracted worksheet(s) 'Sheet2' by name and created JSON and TXT outputs |
解析済みデータ構造:
| ワークシート名 | 行データ |
|---|---|
| シート2 | 列ヘッダーをキーとする行オブジェクトの配列 |
注:このアクションは2つのバイナリ出力を返します。 data_json (JSON フォーマット)と data_txt (TXT形式)どちらも同じ抽出ワークシートデータを含んでいます。 parsedData オブジェクトは、抽出されたデータに直接アクセスします。 JSON 応答。
スキーマビュー
レスポンスのデータ構造と型:
1 item
jsonFileName: T excel_extracted.json
txtFileName: T excel_extracted.txt
jsonFileSize: # 206933
txtFileSize: # 206933
success: ☑ true
originalFileName: T myExcelFile.xlsx
extractBy: T name
worksheetNames: T Sheet2
parsedData: {} Object
  Sheet2: [] Array
    [0]: {} Object
      "": # 1
      First Name: T Dulce
      Last Name: T Abril
      Gender: T Female
      Country: T United States
      Age: # 32
      Date: T 15/10/2017
      Id: # 1562
    [1]: {} Object
      "": # 2
      First Name: T Mara
      Last Name: T Hashimoto
      Gender: T Female
      Country: T Great Britain
      Age: # 25
      Date: T 16/08/2016
      Id: # 1582
    [2]: {} Object
      "": # 3
      First Name: T Philip
      Last Name: T Gent
      Gender: T Male
      Country: T France
      Age: # 36
      Date: T 21/05/2015
      Id: # 2587
message: T Successfully extracted worksheet(s) 'Sheet2' by name and created JSON and TXT outputs
タイプ指標:
T= String (文章)#= 番号☑= Boolean[]= Array{}= Object
バイナリデータビュー
抽出されたワークシートデータは、2 つのバイナリ ファイルとして返されます。 JSON 1つはフォーマット、もう1つはTXTフォーマットです。
data_json
─────────────────────────────
File Name: excel_extracted.json
File Extension: json
Mime Type: application/json
File Size: 207 kB
data_txt
─────────────────────────────
File Name: excel_extracted.txt
File Extension: txt
Mime Type: text/plain
File Size: 207 kB
どちらのバイナリファイルにも、抽出された同じワークシートデータが異なる形式で含まれています。 parsedData オブジェクト JSON このレスポンスは、バイナリファイルを解析することなく、構造化データへの直接アクセスを提供します。
バイナリデータアクセス:
- JSON バイナリオブジェクト:
$binary.data_json.data - TXTバイナリオブジェクト:
$binary.data_txt.data - Base64 コンテンツ両方のフォーマットで直接使用可能
- ファイル操作ダウンロード、メール送信、または保存の準備ができました
ユースケース
データの完全なエクスポートと移行
- Excelワークブック全体を抽出して JSON システム移行、データアーカイブ、およびバックアップ操作
- 複数シートの Excel ファイルを変換して JSON クラウドストレージとデータベースのインポート形式
- ワークシートデータをすべてエクスポートします API 統合とシステム間同期
複数シートの処理と分析
- 複数のワークシートを同時に抽出して並列処理を行う n8n ワークフロー
- 異なるビジネスロジックと変換を用いて、異なるワークシートタブを処理する
- ワークブックのデータを外部データと統合する APIs データ分析プラットフォーム
ビジネスインテリジェンスとデータ統合
- Excelデータをエクスポートして JSON ビジネスインテリジェンスツールおよび分析プラットフォーム向け
- Excelレポートを構造化データに変換する JSON 自動レポート作成とダッシュボード更新
- Excelデータを統合する CRM システム、データベース、クラウドサービス