Excelワークシートから行を抽出する n8n アクション
PDF4me 行を抽出する ワークシートのスライスをすぐに使える形式に変換します JSON 内で n8n0 から始まる行/列の範囲を指定し、最初の行をヘッダーにするかどうか、非表示または空の行をスキップするかどうか、値が型付きのままになるかどうか (数値、ブール値、 ISO 日付)またはテキストに強制されます。Excel データをパイプするのに最適です。 APIsデータベース、または追加の PDF4me 行動。
関連ブログ記事
この機能に関するブログ記事はまだありません。近日公開予定です。
その間、PDF4me ブログを閲覧して、あらゆるプラットフォームのチュートリアルやワークフローをご覧ください。
ブログをご覧ください →
設定
追加する PDF4me 「Extract Rows」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成
- 追加する PDF4me ワークフローへのノード
- 「Excelワークシートから行を抽出する」アクションを選択します。
- Excelソースと抽出ウィンドウを指定してください。
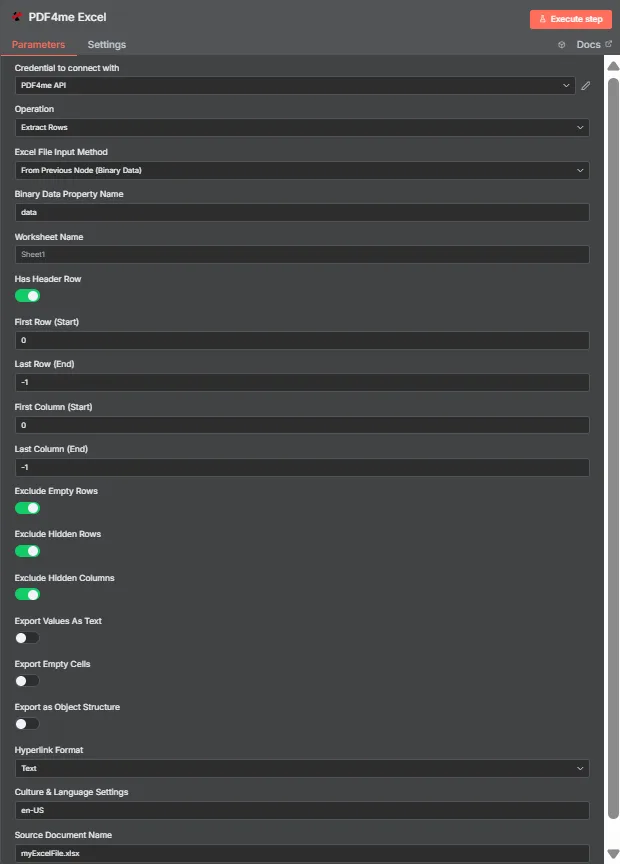
パラメータ
重要: アスタリスク(***)が付いているパラメータは必須です。行/列インデックスは 0ベース (行0=Excelの行1)
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| 入力データ型*** | String | Excel ソースセレクター (Binary Data、 Base64 String、 URL) | Binary Data |
| 入力バイナリフィールド*** | バイナリ | 必要な場合 Binary Data 選択されました。 | {{ $binary.data }} |
| Base64ドキュメントの内容*** | String | 必要な場合 Base64 String 選択されました。 | UEsDBBQAAAA... |
| ドキュメントURL*** | String | 必要な場合 URL 選択されています。公開ファイルへのリンク。 | https://files.example.com/report.xlsx |
| ファイル名*** | String | 拡張子付きの論理的なワークブック名。 | analytics.xlsx |
| ワークシート名 | String | 読むべきワークシート。空欄=最初のシート。 | Summary |
| 最前列*** | 番号 | 抽出開始行番号(0から始まる)。 | 0 |
| 最後列 | 番号 | 0 から始まる終了行。 -1 最後のデータ行まで読み込む。 | -1 |
| 最初の列 | 番号 | 0から始まる開始列(0=A列)。 | 0 |
| 最後の列 | 番号 | 0 から始まる終了列。 -1 最後のデータ列について。 | -1 |
| ヘッダー行があります | Boolean | true 使用する First Row 列ヘッダーとして扱い、データから除外します。 | true |
| 非表示行を除外する | Boolean | Excelで非表示になっている行をスキップする。 | false |
| 非表示の列を除外する | Boolean | 非表示の列はスキップします。 | false |
| 空の行を除外する | Boolean | すべてのセルが空の行を削除します。 | true |
| 空のセルをエクスポートする | Boolean | 空の文字列値を持つ空のセルを省略するのではなく、含めるようにしてください。 | false |
| 値をテキストとしてエクスポート | Boolean | すべての値を文字列に強制的に変換する。 false 在来種を保存する。 | false |
| バイナリデータ出力名*** | String | バイナリ スロットにシリアル化されたデータを格納する JSON (PDF4me リターン JSON バイト) | document |
出力
出力パラメータ
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
| 成功 | Boolean | PDF4me 動作状況 - Boolean 行抽出処理の成否を示すフラグ。 PDF4me リターン true 業務の成功と false エラーが発生した場合 | true |
| オリジナルファイル名 | String | 元のExcelドキュメントのファイル名 - 入力Excelドキュメントファイルの名前 | myExcelFile.xlsx |
| ワークシート名 | String | ワークシート名 - 行が抽出されたワークシートの名前 | First Worksheet |
| hasHeaderRow | Boolean | ヘッダー行の状態 - 最初の行がヘッダーとして扱われたかどうかを示します。 true ヘッダーが使用された場合、 false さもないと | true |
| ファーストロウ | 番号 | 最初の行のインデックス(0から始まる) - 抽出された最初の行の0ベースのインデックス | 0 |
| 最後の行 | 番号 | 最終行インデックス(0から始まる) - 抽出された最後の行の0から始まるインデックス。 -1 最後のデータ行への抽出を示します | 2 |
| 最初の列 | 番号 | 最初の列のインデックス(0から始まる) - 抽出された最初の列の0から始まるインデックス(0 = 列A) | 0 |
| 最後の列 | 番号 | 最終列インデックス(0から始まる) - 抽出された最後の列の0から始まるインデックス。 -1 最後のデータ列への抽出を示します | -1 |
| 空の行を除外する | Boolean | 空行の除外 空の行が除外されたかどうかを示します。 true 除外された場合、 false 含まれている場合 | true |
| 非表示行を除外する | Boolean | 非表示行の除外 非表示行が除外されたかどうかを示します。 true 除外された場合、 false 含まれている場合 | true |
| 非表示の列を除外する | Boolean | 非表示列の除外 - 非表示の列が除外されたかどうかを示します。 true 除外された場合、 false 含まれている場合 | true |
| exportValuesAsText | Boolean | テキストエクスポートモード - 値がテキストとしてエクスポートされたかどうかを示します。 true 強制的に紐を引かれた場合、 false ネイティブタイプが保存されている場合 | false |
| 空のセルをエクスポートする | Boolean | 空のセルの輸出 - 空のセルがエクスポートされたかどうかを示します。 true 空の文字列が含まれている場合、 false 省略した場合 | false |
| exportAsObject | Boolean | オブジェクトエクスポートモード - データがオブジェクト形式でエクスポートされたかどうかを示します | false |
| ハイパーリンク形式 | String | ハイパーリンク形式 抽出データ内のハイパーリンクに使用されるフォーマット。値: "テキスト"、"URL"など。 | Text |
| 文化 | String | 文化/地域コード - データ抽出に使用される文化コード(例:「en-US」、「de-DE」、「fr-FR」) | en-US |
| 抽出された行 | 番号 | 抽出された行数 - 正常に抽出された行の総数 | 1 |
| 抽出データ | Object | 抽出されたデータオブジェクト - 抽出された行データを含むネストされたオブジェクト(rowData配列付き) | {"rowData": [{"Column1": 1, "First Name": "Dulce"}]} |
| メッセージ | String | 作戦メッセージ - 行抽出操作の結果を示す説明メッセージ(抽出された行数とワークシート名を含む) | Successfully extracted 1 row(s) from worksheet 'First Worksheet' |
N8N 行動対応
の PDF4me Excelワークシートから行を抽出する API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
[
{
"success": true,
"originalFileName": "myExcelFile.xlsx",
"worksheetName": "First Worksheet",
"hasHeaderRow": true,
"firstRow": 0,
"lastRow": 2,
"firstColumn": 0,
"lastColumn": -1,
"excludeEmptyRows": true,
"excludeHiddenRows": true,
"excludeHiddenColumns": true,
"exportValuesAsText": false,
"exportEmptyCells": false,
"exportAsObject": false,
"hyperlinkFormat": "Text",
"culture": "en-US",
"rowsExtracted": 1,
"extractedData": {
"document": null,
"fileName": null,
"success": true,
"errorMessage": null,
"rowData": [
{
"Column1": 1,
"First Name": "Dulce",
"Last Name": "Abril",
"Gender": "Female",
"Country": "United States",
"Age": 32,
"Date": "15/10/2017",
"Id": 1562
},
{
"Column1": 2,
"First Name": "Mara",
"Last Name": "Hashimoto",
"Gender": "Female",
"Country": "Great Britain",
"Age": 25,
"Date": "16/08/2016",
"Id": 1582
}
]
},
"message": "Successfully extracted 1 row(s) from worksheet 'First Worksheet'"
}
]
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| 成功 | true |
| オリジナルファイル名 | myExcelFile.xlsx |
| ワークシート名 | First Worksheet |
| hasHeaderRow | true |
| ファーストロウ | 0 |
| 最後の行 | 2 |
| 最初の列 | 0 |
| 最後の列 | -1 |
| 空の行を除外する | true |
| 非表示行を除外する | true |
| 非表示の列を除外する | true |
| exportValuesAsText | false |
| 空のセルをエクスポートする | false |
| exportAsObject | false |
| ハイパーリンク形式 | Text |
| 文化 | en-US |
| 抽出された行 | 1 |
| 抽出データ | rowData配列を含むオブジェクト |
| メッセージ | Successfully extracted 1 row(s) from worksheet 'First Worksheet' |
抽出されたデータオブジェクト:
| パラメータ | 価値 |
|---|---|
| 書類 | null |
| ファイル名 | null |
| 成功 | true |
| エラーメッセージ | null |
| 行データ | 抽出された行オブジェクトの配列 |
注:rowDataには、抽出された行オブジェクトが、列ヘッダーをキーとする配列として格納されています。
スキーマビュー
レスポンスのデータ構造と型:
1 item
success: ☑ true
originalFileName: T myExcelFile.xlsx
worksheetName: T First Worksheet
hasHeaderRow: ☑ true
firstRow: # 0
lastRow: # 2
firstColumn: # 0
lastColumn: # -1
excludeEmptyRows: ☑ true
excludeHiddenRows: ☑ true
excludeHiddenColumns: ☑ true
exportValuesAsText: ☑ false
exportEmptyCells: ☑ false
exportAsObject: ☑ false
hyperlinkFormat: T Text
culture: T en-US
rowsExtracted: # 1
extractedData: {} Object
document: null
fileName: null
success: ☑ true
errorMessage: null
rowData: [] Array
[0]: {} Object
Column1: # 1
First Name: T Dulce
Last Name: T Abril
Gender: T Female
Country: T United States
Age: # 32
Date: T 15/10/2017
Id: # 1562
[1]: {} Object
Column1: # 2
First Name: T Mara
Last Name: T Hashimoto
Gender: T Female
Country: T Great Britain
Age: # 25
Date: T 16/08/2016
Id: # 1582
message: T Successfully extracted 1 row(s) from worksheet 'First Worksheet'
タイプ指標:
T= String (文章)#= 番号☑= Boolean[]= Array{}= Objectnull= ヌル値
バイナリデータビュー
抽出されたデータは次のように返されます JSON レスポンス内で。行データに直接アクセスします。 extractedData.rowData 配列:
extractedData
─────────────────────────────
rowData: Array of row objects
success: true
errorMessage: null
データアクセス:
- 行データ配列:
$json.extractedData.rowData - 個々の行:
$json.extractedData.rowData[0] - 列の値:
$json.extractedData.rowData[0]["First Name"] - JSON 応答: 構造化された形で利用可能 JSON で n8n 応答
ユースケース
- API フィード: フィルタリングされた行を抽出して直接プッシュします REST エンドポイントまたはWebhookコンシューマー。
- データベース取り込みExcelレポートを構造化された形式に変換します JSON SQL/NoSQLストアに挿入する前に毎晩実行します。
- 検証と品質保証手動でエクスポートすることなく、ルールチェック用の範囲を取得したり、アラートを送信したり、他のワークフローを強化したりできます。