AI - ドキュメントパーサー n8n
このノードの機能
PDF4me AIドキュメントパーサー 保存済みのスクリプトを実行することで、あらゆるドキュメントから構造化データを抽出します。 AI アナライザ あなたの PDF4me ファイルに対してアカウントを作成します。固定パーサー(AI-Invoice Parser、AI-Process Contract)とは異なり、 AI アナライザーID アナライザーのドロップダウンから PDF4me ダッシュボードなので、同じノードが請求書、発注書、領収書、カスタムフォーム、ラボレポート、内部テンプレートなど、スキーマで記述したあらゆるものを処理します。 解析 単一スキーマまたは 分類する 1回の呼び出しで複数のドキュメントバリアントを分析するアナライザー。動的な値を返します。 JSON スキーマと _メタデータ ブロック、バイナリファイルなし。
テスト用サンプル請求書
このサンプルベンダー請求書を使用して、ワークフローをライブデータに向ける前に、ノードがエンドツーエンドで動作することを確認します。バイナリ入力としてマッピングし、 default_invoice_extraction として AI アナライザーID。
認証 API リクエスト
毎 PDF4me ノード n8n 有効な 接続するための認証情報. 作成または選択して、 PDF4me API ワークフローが認証できるようにするためのキー AI 抽出要求を安全に実行します。同じ認証情報で、 AI アナライザーID GetAnalyzerId によるドロップダウン API。
まずアナライザーをセットアップしてください
- アナライザーリスト(ステップ 1–2):
https://dev.pdf4me.com/dashboard/#/ai-document-parser/ - 分析装置の詳細(ステップ 3–5):
https://dev.pdf4me.com/ai-document-parser/?id=<analyzer-guid>
見逃してはならない重要な事実
_メタデータ オブジェクトには常に成功、メッセージ、タイムスタンプ、ソースファイル名、アナライザーID、および操作が追加されます。 出力バイナリフィールド名。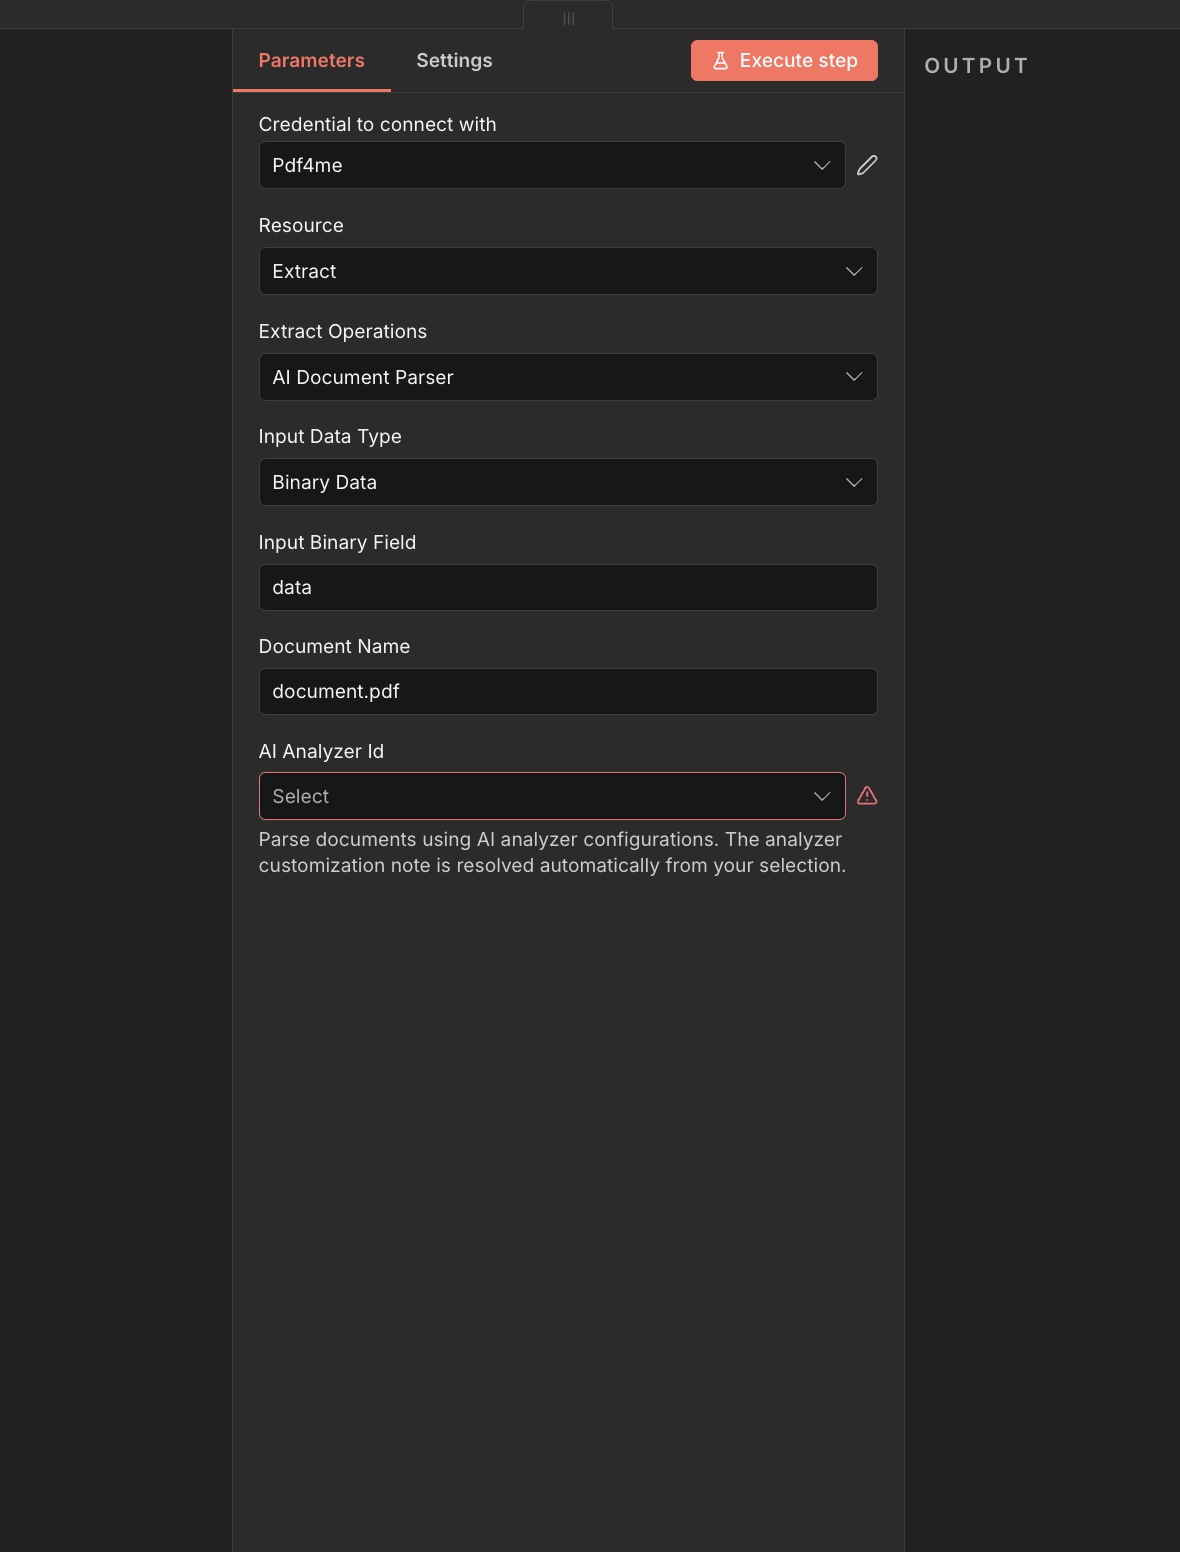
フルノードパネル: 抽出 → AI バイナリデータ入力によるドキュメントパーサー。 AI アナライザーID 実行前に。
パラメータ
- アナライザーリスト(ステップ 1–2):
https://dev.pdf4me.com/dashboard/#/ai-document-parser/ - 分析装置の詳細(ステップ 3–5):
https://dev.pdf4me.com/ai-document-parser/?id=<analyzer-guid>
必須 n8n UI: 接続に使用する認証情報、入力データタイプ、ドキュメント名、 AI アナライザー ID。条件付き必須フィールド (入力バイナリフィールド、Base64 ドキュメントコンテンツ、またはドキュメント URL) は、一致する入力データタイプが選択された場合にのみ表示されます。 出力バイナリフィールド名 そしていいえ 詳細オプション/カスタムプロファイル この作戦において。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | How the document is supplied. Binary Data reads from a previous node (most common). Default is `Binary Data`. Base64 String accepts an encoded document. URL downloads the document from a public link. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property on the incoming n8n item that holds the document. Required when Input Data Type is Binary Data. Defaults to data. Error reports which property was missing when the name is wrong. | data |
| Base64 Document Content | Conditional | Base64-encoded document. Required when Input Data Type is Base64 String. Data-URL style prefixes (text before the comma) are stripped automatically. | JVBERi0xLjQK... |
| Document URL | Conditional | Publicly reachable HTTPS URL to the document. Required when Input Data Type is URL. Must be a valid full URL. | https://example.com/document.pdf |
| Document Name | Required | Filename used by PDF4me for processing. Default is `document.pdf`. With Binary Data, the uploaded file name is used for upload but your explicit Document Name value takes precedence in the API call when set. Use a real extension (.pdf, .png, .jpg, etc.) so PDF4me handles the file correctly. | document.pdf |
| AI Analyzer Id | Required | The saved Analyzer that controls extraction. Create Analyzers at https://dev.pdf4me.com/dashboard/#/ai-document-parser/ (+ Add), then edit schemas on https://dev.pdf4me.com/ai-document-parser/?id=<analyzer-guid>. Dropdown populated via GetAnalyzerId API. Sent as customisationNote. Pick Parse for one schema or Classify for many variants. | aaaa133 |
入力データタイプのオプション
ドキュメントがノードに入力される方法を選択してください。この選択によって、後続のフィールドが変更されます。
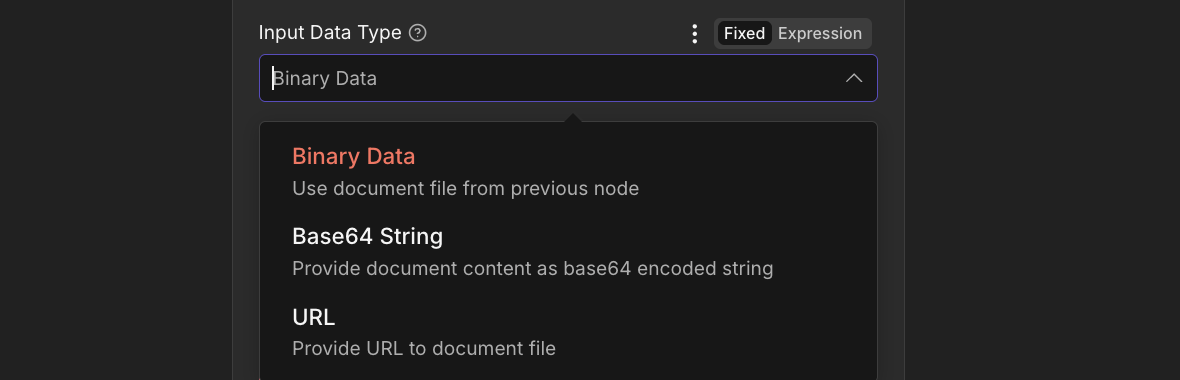
入力データタイプ。バイナリデータ(デフォルト)、Base64文字列、または URL。
バイナリデータデフォルト: 前のノードからのファイル入力バイナリフィールド バイナリフィールド名(デフォルト) データ) ドキュメント名を上書きしない限り、アップロードされたファイル名が使用されます。Base64文字列エンコードされたドキュメントをインラインで表示Base64ドキュメントの内容データURLスタイルの接頭辞(カンマより前のテキスト)は自動的に削除されます。 文書名 適切な拡張ドライブのフォーマット検出機能付き。URL公開リンクからダウンロードドキュメントのURL。 PDF4me ドキュメントを直接取得します。処理するファイル名は、 URL 可能な場合はパス、またはドキュメント名から取得します。AI アナライザーIDドロップダウン
ドロップダウンリストはあなたの PDF4me アカウント経由で GetAnalyzerId API フィールドを開くと、各オプションは、 PDF4me ダッシュボード。処理対象のドキュメントタイプとスキーマが一致するものを選択してください。
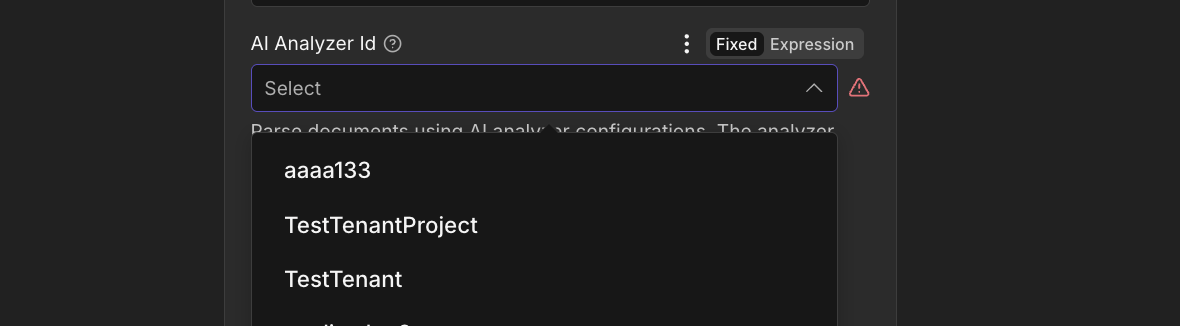
AI アナライザー ID ドロップダウンは、 PDF4me アカウント。
フィールドタイプ: "テーブル" ネストされた行と フィールドメソッド (デフォルトを抽出し、派生/正規化のために生成する)。ドロップダウンメニューが空ですか? ノードは表示します 「GetAnalyzerId はアナライザーオプションを返しませんでした」 アカウントにアナライザーがない場合、または認証情報が到達できない場合 API. 開く アナライザー一覧 アナライザーを少なくとも 1 つ追加します。 アナライザーの詳細 ページを確認してから、 API 入力 n8n 資格情報。
出力フィールド
成功したランは1 n8n アイテム JSON バイナリファイルはありません。トップレベルのキーはアナライザーのスキーマと一致します。 _metadata オブジェクトは常に追記されます。
| 分野 | タイプ | 内容物 |
|---|---|---|
Top-level extracted fields | Dynamic | One key per field defined in your Analyzer schema (string, number, date, or nested table rows). Names match fieldName exactly. |
_metadata.success | Boolean | true on a successful parse. |
_metadata.message | String | "Document parsed successfully using AI Document Parser". |
_metadata.processingTimestamp | String | ISO timestamp of the parse. |
_metadata.sourceFileName | String | Document name used for processing. |
_metadata.aiAnalyzerId | String | The Analyzer Id you selected (sent as customisationNote to the API). |
_metadata.operation | String | "aiDocumentParser". |
rawContent (fallback only) | String | If the API returns plain text instead of JSON and parsing fails, the node wraps the response as { "rawContent": "<api response string>" } at the top level. |
クイックセットアップ
- まずアナライザーを構築します。 アナライザー一覧、 クリック +追加明確なアナライザーIDを入力し、 解析 または 分類する行を保存してから、ドキュメントスキーマを追加します。 アナライザーの詳細 ページを参照してください。 Parseセットアップガイド または Classify設定ガイド 完全なスキーマルールについては、以下を参照してください。
fieldType: "table"ネストされた行とfieldMethod(抽出または生成) - あなたの n8n ワークフロー、クリック + そして検索する PDF4me。 セット リソース に 抽出する そして 抽出操作 に AIドキュメントパーサー。
- で 接続するための認証情報選択してください PDF4me 資格情報または貼り付け API 鍵。
- セット 入力データタイプバイナリデータ(デフォルト)は前のノードから読み取り、最も一般的です。
- 一致する入力フィールドに入力してください(入力バイナリフィールド、 Base64ドキュメントの内容、 または ドキュメントのURL)
- 文書名デフォルト設定を上書きする
document.pdf正しい拡張子を付けた実際のファイル名を使用する。 - 選択してください AI アナライザーID ドロップダウンメニューから選択してください(アカウントから読み込まれます)。
- ノードを実行します。出力項目には、最上位レベルの解析済みフィールドに加えて、
_metadataSet、Code、Google Sheets、Airtable、データベース、メール、または任意のダウンストリームノードにルーティングします。
典型的な構成
ワークフローの例Common n8n workflow patterns using AI Document Parser.
- メールトリガー(IMAP)は新しいメッセージを受信すると作動します。 PDF 添付ファイル。
- AI ドキュメントパーサーは、入力データタイプがバイナリデータ、ドキュメント名が添付ファイル名に設定された状態で実行されます。 AI アナライザーIDをあなたの
請求書パーサー分析装置。 - Googleスプレッドシート 追加する 請求書番号、ベンダー名、合計金額、支払期日をAPトラッカーに書き込みます。
- 監視フォルダには様々な情報が届きます PDFs クライアントABC、クライアントXYZ、そしてロングテールから。
- AI ドキュメントパーサーは、分類アナライザーID(ベンダーごとに1つのスキーマ)に設定されています。
- Switchノードは、応答で返された一致する分類名に基づいて分岐し、それぞれの結果を対応する下流テーブルに送信します。
- Webhookは、ポータルからドキュメントリンクを受信します。
- AI ドキュメントパーサーは入力データタイプで実行されます URL そして、カスタムフォームのアナライザーID。
- 出力 JSON Dataverse / Airtable / Postgres に書き込み、新しいレコードを作成します。
- スキャナーの出力は、幅の広い枠で囲まれたフォルダに保存されます。
- AIによる文書の自動トリミング (リソース AI) 境界線をトリミングします。
- AI ドキュメントパーサーは、一致するアナライザーIDを持つ切り抜きバイナリに対して実行されます。
- 解析済み JSON 通常通り下流へ流れます。
- AI ドキュメントパーサーは構造化されたフィールドを返します。
- コードノードは、必須フィールドを検証し、ビジネスルールを適用します。
- 有効な場合、 HTTP リクエストにはCRMからのベンダーデータが反映されます。反映されない場合は、手動レビューのためにSlackにアラートが送信されます。
実践的なヒント
トラブルシューティング
実行前にドロップダウンリストからアナライザーを選択してください。このフィールドは空欄にできません。
整列 入力バイナリフィールド 前のノードと(多くの場合) データエラーメッセージには、どのプロパティが欠落していたかが報告されます。
base64データが空であるか、ファイルが見つかりません。該当する入力データタイプフィールドにコンテンツを入力してください。
チェック ドキュメントのURL 完全で有効な URL (スキーム + ホスト + パス)
アカウントにアナライザーがないか、認証情報に問題があります。アナライザーをアカウントに作成してください。 PDF4me ダッシュボードまたは確認 API キー n8n 資格情報。
チートシート
| 分野 | 価値 |
|---|---|
| Resource | Extract |
| Operation | AI Document Parser |
| Input Data Type | Binary Data |
| Input Binary Field | data |
| Document Name | form.pdf (with the real extension) |
| AI Analyzer Id | (pick from the dropdown loaded from your account) |
| Credentials | PDF4me API credential |
よくある質問
関連アクション
他のプラットフォームでの同じタスク
/v2/FlowV2/AiDocumentParser カスタムバックエンドコードやPostmanテスト用。