得る PDF メタデータ n8n アクション
PDF4me 得る PDF メタデータ 包括的な文書情報と技術特性を抽出します PDF ファイルを通じて n8n 自動化ワークフロー。プロセス PDFs 経由 n8n トリガー、バイナリデータ、base64文字列、または公開 URLs 文書のプロパティ、ページ数、ファイルサイズ、作成日、作成者情報、技術仕様などの詳細なメタデータを取得します。このエンタープライズグレードのソリューションは、正確なプロパティ分析と信頼性の高いメタデータ抽出をシームレスに必要とする文書管理システム、コンプライアンスワークフロー、コンテンツ分析、監査証跡、自動文書検査に最適です。 n8n 統合。
設定
追加する PDF4me 「PDFメタデータの取得」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「PDFメタデータの取得」アクションを選択します。
- 入力パラメータを設定します(下記参照)。
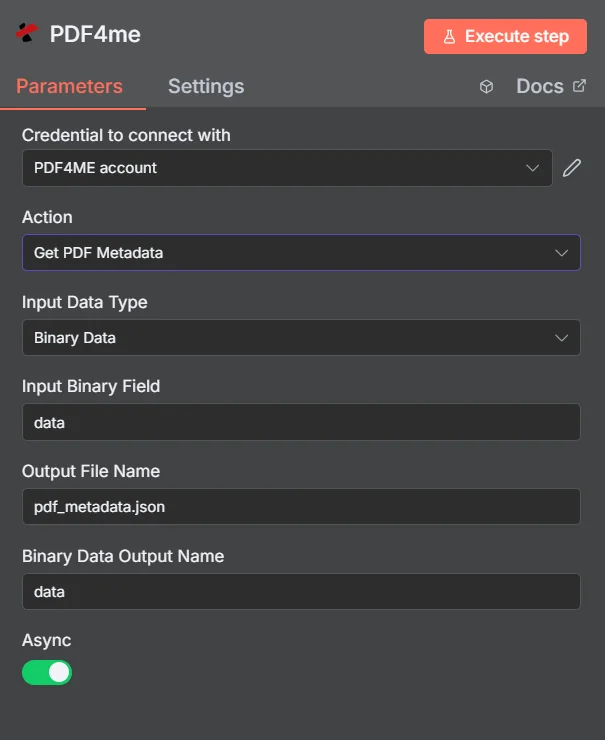
パラメータ
PDFメタデータ取得アクションのパラメータ一覧。これらのパラメータを設定して制御します。 PDF メタデータの抽出。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract metadata from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file. Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF content. Shown when Input Data Type is Base64 String. | UEsDBBQABgAI... |
| PDF URL | Conditional | URL to the PDF file to extract metadata from. Shown when Input Data Type is URL. | |
| Output File Name | Optional | Name for the output metadata file. Default is `pdf_metadata.json`. | pdf_metadata.json |
| Binary Data Output Name | Optional | Name of the binary property that will contain the JSON metadata file. Default is `data`. | data |
| Async | Optional | Ignored: the node always sends the request with IsAsync true, whatever this is set to. Default is `Yes`. | Yes |
出力
出力パラメータ
| 分野 | タイプ | 内容物 |
|---|---|---|
data | Binary | A JSON file with the same content as the item's JSON (named after Output File Name, with a `.json` extension). |
商品の JSON は PDF4me 返されたメタデータ応答に加えて _metadata 成功の場合、メッセージ、処理タイムスタンプ、ソースファイル名、操作 (getPdfMetadata)
商品の JSON は PDF4me返されたメタデータ応答に加えて _metadata 成功の場合、メッセージ、処理タイムスタンプ、ソースファイル名、操作 (getPdfMetadata)
N8N 行動対応
の PDF4me PDFメタデータを取得する API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
[
  {
    "success": true,
    "message": "PDF metadata extracted successfully",
    "fileName": "pdf_metadata.json",
    "mimeType": "application/json",
    "fileSize": 125430,
    "docName": "pdf_metadata.json",
    "metadataExtracted": true,
    "metadataFields": 25
  }
]
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| success | true |
| message | PDF metadata extracted successfully |
| fileName | pdf_metadata.json |
| mimeType | application/json |
| fileSize | 125430 |
| docName | pdf_metadata.json |
| metadataExtracted | true |
| metadataFields | 25 |
スキーマビュー
レスポンスのデータ構造と型:
1 item
success: ☑ true
message: AB PDF metadata extracted successfully
fileName: AB pdf_metadata.json
mimeType: AB application/json
fileSize: # 125430
docName: AB pdf_metadata.json
metadataExtracted: ☑ true
metadataFields: # 25
タイプ指標:
AB= String#= 番号☑= Boolean
バイナリデータビュー
実際のメタデータファイルデータと情報:
data
─────────────────────────────
File Name: pdf_metadata.json
File Extension: json
Mime Type: application/json
File Size: 122.5 KB
バイナリデータアクセス:
- n8n バイナリオブジェクト:
$binary.data.data - Base64 コンテンツ直接使用可能
- ファイル操作ダウンロード、メール送信、または保存の準備ができました
ユースケース
文書分析および検査
- コンプライアンス監査のために文書のプロパティと技術情報を抽出します。
- 分析 PDF 品質評価と検証のための構造と内容
- セキュリティ分析とコンテンツ検証のためにドキュメントのメタデータを検査する
コンテンツ管理と組織化
- 文書の自動分類とタグ付けのためのメタデータを抽出する
- 検索最適化とインデックス作成のために文書のプロパティを分析する
- コンテンツ管理システム統合のためのプロセス文書情報
エンタープライズ文書インテリジェンス
- 文書処理ワークフローにおけるメタデータ抽出を自動化する
- ビジネスインテリジェンスとレポート作成のために文書のプロパティを分析する
- 文書ライフサイクル管理およびアーカイブのための技術的な詳細情報を抽出する