ページを抽出する PDF で n8n
ページを抽出する PDF は PDF4me ノードアクション n8n 新しい PDF のみを含む pages リストを作成します。契約書から署名ページを抜き出したり、マニュアルから特定の章だけを抽出したり、後続のステップに要約だけを渡したりするのに使用できます。 pages 文書全体ではなく、
このノードの機能
PDF4me: ページを抽出する PDF 取る PDF バイナリデータから、 Base64 Stringまたは URL そして、 pages に名付けられた ページ番号そのフィールドはアクション全体です。単一の pagesハイフンで区切られた範囲、混合リスト、および文書の末尾まで続くオープン範囲など、あらゆる範囲が対象となります。ワークフローのステップとして実行されるため、エディタを開かずに到着したすべてのファイルに同じ抽出ルールが適用されます。
関連ブログ記事
この機能に関するブログ記事はまだありません。近日公開予定です。
その間、PDF4me ブログを閲覧して、あらゆるプラットフォームのチュートリアルやワークフローをご覧ください。
ブログをご覧ください →
認証 API リクエスト
毎 PDF4me ノード n8n 有効な 接続するための認証情報. 作成または選択して、 PDF4me API ワークフローが抽出要求を安全に認証できるようにするためのキー。
見逃してはならない重要な事実
ページ番号だけが重要なフィールドです
必須項目であり、検証済みです。空欄のままにしてください。 n8n ノードが実行される前に、そのフィールドにフラグを立てます。
範囲指定なしの場合、ページ数が変動します。
執筆
10- これは10ページ目から最後までを意味するので、1つの設定で長さの異なる文書に対応できます。ページ番号は1から始まります
最初のページは0ではなく1です。前のコードノードがプログラムでページリストを生成する際に、この点に注意してください。
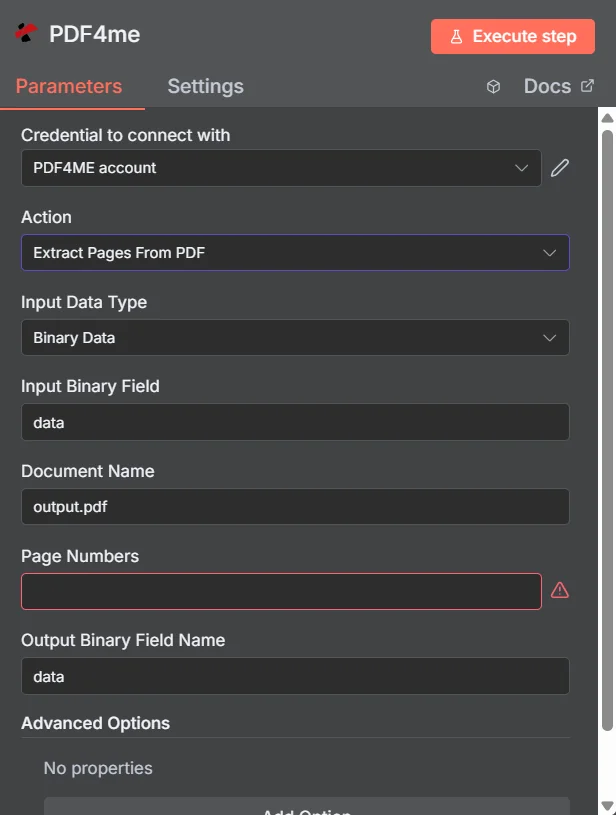
PDF4me ページを抽出する PDF パラメーターパネル n8n
ページの抽出と分割 PDF
どちらもより小さな文書を生成しますが、異なる質問に答えます。抽出では、 pages 残しておきたい部分を指定すると、分割では文書全体をどのように分割するかを尋ねられます。
| 質問 | ページを抽出する PDF | スプリット PDF |
|---|---|---|
| How many files come back | One PDF holding the pages you listed | Several PDFs covering the whole document |
| What happens to unlisted pages | They are absent from the output | They still appear, in another output file |
| Typical use | Pull the signature page, one chapter, or a summary section | Break a bundle into per-invoice or per-section files |
| Driven by | An explicit page list you supply | A split rule such as page count, text, or barcode |
抽出ページはどのパラメータから取得されますか? PDF 必要?
必須: アクション、入力データタイプ、その入力タイプに一致するフィールド、ドキュメント名、およびページ番号。出力バイナリフィールド名には、以下の作業デフォルト値があります。 データ、そして詳細オプションは最初は空です。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract pages from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file (usually "data" for file uploads). Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF document content. Shown when Input Data Type is Base64 String. | JVBERi0xLjQK... |
| PDF URL | Conditional | URL to the PDF file to extract pages from. Shown when Input Data Type is URL. | |
| Document Name | Optional | Name of the output PDF. When left at `output.pdf`, the input file's name is used (for Binary Data and URL input). Default is `output.pdf`. | output.pdf |
| Page Numbers | Required | Page numbers to extract (e.g. "1" or "1,3,5" or "2-4"). | 1,3,5-8 |
| Output Binary Field Name | Optional | Name of the binary property to store the output PDF file. Default is `data`. | data |
| Advanced Options | Optional | Optional settings, collapsed behind Add Option. | Add Option |
| Custom Profiles | Optional | Use 'JSON' to adjust custom properties. Review Profiles at https://dev.pdf4me.com/apiv2/documentation/ to set extra options for API calls and may be specific to certain APIs. | |
出力フィールド
成功したランは1 n8n 抽出されたアイテム PDF。
出力
ノードが返すフィールド。
| 分野 | タイプ | 内容物 |
|---|---|---|
fileName | String | File name of the resulting file. |
mimeType | String | MIME type of the resulting file, for example `application/pdf`. |
fileSize | Number | Size of the resulting file in bytes. |
success | Boolean | True when the operation succeeded. |
message | String | Status message, `Pages extracted successfully`. |
docName | String | Name of the input document as sent to PDF4me. |
data | Binary | A PDF containing only the extracted pages. |
抽出ページの設定方法 PDF で n8n?
- 追加 PDF4me あなたの n8n ワークフローを選択し、 ページを抽出する PDF アクション。
- で 接続するための認証情報選択してください PDF4me 認証情報またはクリック 新しい認証情報を作成する そしてあなたの API 鍵。
- セット 入力データタイプ に バイナリデータ (デフォルト)、 Base64 String、 または URL 対応するソースを提供する PDF 分野。
- セット 文書名 ソースファイルには、
.pdf拡大。 - 入力 ページ番号 リスト、範囲、混合リスト、またはオープン範囲を使用します。
- 離れる 出力バイナリフィールド名 として
data後続のノードが異なるプロパティを期待している場合を除きます。 - ノードを実行し、返されたデータをルーティングします。 PDF 次のステップ(ストレージ、メール、レビューキューなど)へ移行します。
典型的な構成
ワークフローの例Common n8n workflow patterns using Extract Pages From PDF.
契約書から署名ページを取り出す
- 署名済みの契約書はメールの添付ファイルとして届きます。
- ページを抽出する PDF オープンレンジを使用して最後のページを取得します。
- この1枚の用紙は、迅速な参照のために顧客記録に保管されます。
査読者には要約のみを送付してください。
- 長文レポートは定期的に生成されます。
- ページを抽出する PDF 最初の数個は pages 範囲は次のような
1-3。 - 査読者には要約が送付され、完全な報告書はアーカイブに保存される。
マニュアルから章を抜き出す
- サポート依頼では、製品マニュアルの特定のセクションが参照されます。
- ページを抽出する PDF ハイフンで区切られた範囲を持つ章を抽出します。
- 顧客は関連する pages 大きな添付ファイルの代わりに。
抽出後、消化物に統合する
- 複数の資料には、それぞれ保存しておく価値のあるページが1ページずつ含まれている。
- ページを抽出する PDF ドキュメントごとに実行され、そのページを取得します。
- 複数のものを結合する PDFs 結果を1つの要約にまとめます。
実践的なヒント
Use an open range for variable documents
When the page count differs between files, 10- keeps everything from page 10 onward without knowing the total.
Check pagesExtracted against your request
Comparing the returned count with the number of pages you asked for catches a malformed page list before it reaches the customer.
Remember pages start at 1
A code node that builds the list from a zero-based array will be off by one on every document. Add one when generating the string.
Extract before you merge
Pulling the wanted pages from each source first keeps the merge step small and the final document free of filler.
Branch on the success field
Test the returned success boolean before sending the file onward so a failed extraction raises an alert instead of forwarding an empty result.
Reuse one source for several subsets
The original is untouched, so the same PDF can feed two extraction nodes to produce an internal copy and a customer copy in one run.
チートシート
| 分野 | 価値 |
|---|---|
| Action | Extract Pages From PDF |
| Input Data Type | Binary Data |
| Input Binary Field | data |
| Document Name | output.pdf |
| Page Numbers | 1,3,5-8 |
| Output Binary Field Name | data |
| Advanced Options | No properties |
| Credentials | PDF4me API credential |
よくある質問
関連アクション
スプリット PDF
文書全体を1つのファイルにまとめるのではなく、複数のファイルに分割してください。
不要なページを削除する PDF
逆のアプローチ: pages 取り除くのではなく pages 保管する。
複数のものを結合する PDFs
組み合わせる pages あなたは複数の情報源から抽出した情報を1つの要約にまとめました。
ドキュメントを回転する
抽出した出力を送信する前に、ページの向きを正しく調整してください。
他のプラットフォームでの同じタスク
ページを抽出する Make
同じ抽出エンジン Make モジュールに配線され、 Make シナリオ。
ページを抽出する PDF で Zapier
数千ものSaaSアプリやWebhookからページ抽出をトリガーできます。
ページを抽出する Power Automate
Microsoft 365 流れ SharePoint、 OutlookTeams、およびDataverseとの連携。
抽出ページ REST API
生 PDF4me エンドポイント。カスタムバックエンドコードやPostmanテスト用。