式を使用してテキストを抽出する n8n アクション
PDF4me 式によるテキスト抽出 特定のテキストコンテンツを抽出します PDF パターンマッチングと式ベースのフィルタリングを使用したドキュメント n8n 自動化ワークフロー。プロセス PDF離れて n8n トリガー、バイナリデータ、base64文字列、または公開 URLワイルドカードパターン(%)、正規表現、特定のデータフィールド、ページ固有のターゲティング、構造化された出力による柔軟な抽出ルールを使用してテキストを検索および抽出します。このソリューションは、請求書番号の抽出、データフィールドの取得、パターンベースのテキスト検索、自動データ抽出、ドキュメント解析、および柔軟なマッチングとシームレスな統合による正確なテキストターゲティングを必要とするコンテンツ分析ワークフローに最適です。
設定
追加する PDF4me 「式によるテキスト抽出」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「式によるテキスト抽出」アクションを選択します。
- 入力パラメータを設定します(下記参照)。
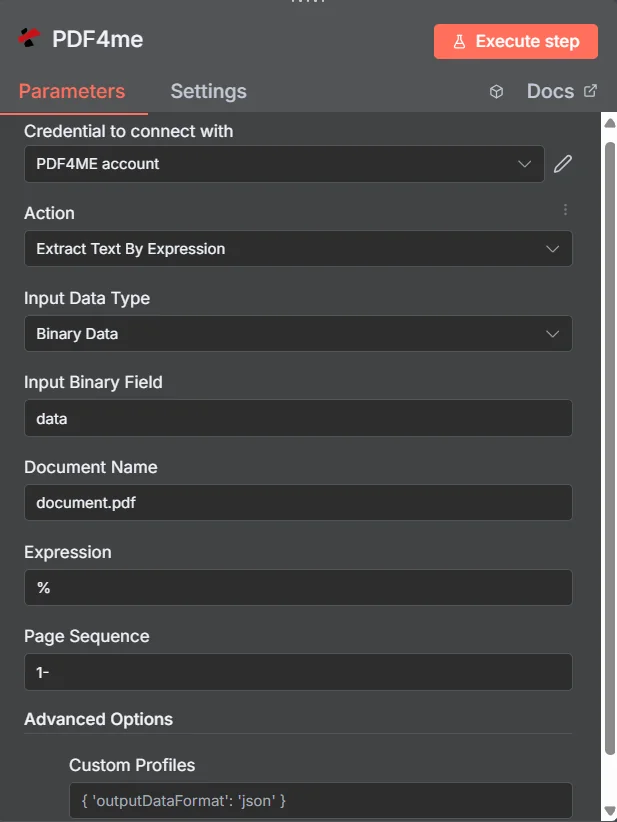
パラメータ
「式によるテキスト抽出」アクションのパラメータ一覧です。これらのパラメータを設定することで、テキスト抽出を制御できます。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract text from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file (usually "data" for file uploads). Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF document content. Shown when Input Data Type is Base64 String. | JVBER... |
| PDF URL | Conditional | URL to the PDF file to extract text from. Shown when Input Data Type is URL. | https://abc.com/document.pdf |
| Document Name | Optional | Name of the document (used for processing). Default is `document.pdf`. | document.pdf |
| Expression | Required | Regular expression pattern to search for in the PDF. Default is `%`. | % |
| Page Sequence | Optional | Page range to process: "1-" for all pages, "1,2,3" for specific pages, "1-5" for range. Default is `1-`. | 1- |
| Advanced Options | Optional | Optional settings, collapsed behind Add Option. | Add Option |
| Custom Profiles | Optional | Use 'JSON' to adjust custom properties. Review Profiles at https://dev.pdf4me.com/apiv2/documentation/ to set extra options for API calls and may be specific to certain APIs. | { "outputDataFormat": "json" } |
出力
出力パラメータ
| 分野 | タイプ | 内容物 |
|---|---|---|
_metadata | String | Object added by the node: success (always true), message (`Text extracted successfully by expression`), processingTimestamp (time the node received the result, ISO 8601), sourceFileName (the input file's name for Binary Data, the last part of the URL for URL, and Document Name for Base64) and operation (`extractTextByExpression`), plus expression and pageSequence (the values that were used). |
すべての分野 PDF4me 応答はアイテムにコピーされます: テキストは正規表現に一致します (Power Automate コネクタで、 textList)正確なフィールドは PDF4me 応答。
すべての分野の PDF4meの応答はアイテムにコピーされます: テキストは正規表現 (Power Automate コネクタ内) に一致するもの textList)正確なフィールドは以下に依存します PDF4meの返答。
N8N 行動対応
の PDF4me 式によるテキスト抽出 API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
{
  "fileName": "text_extraction_results_1756999697398.json",
  "mimeType": "application/json",
  "fileSize": 106,
  "success": true,
  "message": "Text extraction by expression completed successfully",
  "docName": "document.pdf",
  "expression": "%",
  "pageSequence": "1-2"
}
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| fileName | text_extraction_results_1756999697398.json |
| mimeType | application/json |
| fileSize | 106 |
| success | true |
| docName | document.pdf |
| message | Text extraction by expression completed successfully |
| expression | % |
| pageSequence | 1-2 |
スキーマビュー
レスポンスのデータ構造と型:
fileName: AB text_extraction_results_1756999697398.json
mimeType: AB application/json
fileSize: # 106
success: ✓ true
docName: AB document.pdf
message: AB Text extraction by expression completed successfully
expression: AB %
pageSequence: AB 1-2
タイプ指標:
AB= String#= 番号✓= Boolean
バイナリデータビュー
実際に抽出されたテキストコンテンツデータとメタデータ:
data
─────────────────────────────────────────
File Name: text_extraction_results_1756999697398.json
File Extension: json
Mime Type: application/json
File Size: 106 bytes
ユースケース
データマイニングと情報抽出
- 特定のデータパターン、連絡先情報、構造化データを抽出する PDF データマイニングとビジネスインテリジェンスのためのカスタム式を使用したドキュメント
- 特定の条項、条件、および法的情報を抽出して、法的文書、契約書、および公式記録を処理する。
- カスタム式を使用して特定の財務データ、金額、取引情報を抽出することで、財務報告書、請求書、会計文書を変換します。
コンテンツ分析と調査
- 研究データ、引用文献、学術情報を抽出します PDF 学術研究およびコンテンツ分析のためのカスタム式を使用した文書
- 特定のデータ、測定値、研究結果を抽出して、科学論文、研究文書、技術出版物を処理する。抽出には、ターゲットとなる式を使用する。
- カスタム式を使用して特定の指標、統計、ビジネスデータを抽出することで、ビジネスレポート、市場調査、業界分析を変換します。
コンプライアンスおよび規制関連処理
- コンプライアンスデータ、規制情報、監査の詳細を抽出します。 PDF 規制遵守および監査処理のためのカスタム式を使用した文書
- 特定のコンプライアンスデータ、規格、規制情報を抽出することにより、プロセス品質管理文書、検査報告書、認証資料を処理する。
- カスタム式を使用して特定の規制データ、コンプライアンス指標、および公式情報を抽出することにより、公式文書、許可証、および規制申請を変換します。