テーブルを抽出する PDF 使用 n8n アクション
PDF4me テーブルを抽出する PDF 構造化されたテーブルデータを識別して抽出します PDF 文書を通じて n8n 自動化ワークフロー。プロセス PDF離れて n8n トリガー、バイナリデータ、base64文字列、または公開 URLテーブルを自動的に検出し、セル構造を保持し、データ関係を維持し、ヘッダーと値を抽出し、構造化データを出力する JSON またはExcel形式。このソリューションは、財務報告分析、データデジタル化、統計データ抽出、請求書処理、フォーム分析、および構造化された出力とシームレスな統合による正確なテーブル認識を必要とする自動テーブル抽出ワークフローに最適です。
設定
追加する PDF4me 「テーブルを抽出する」 PDF「ノードをあなたの n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「テーブルを抽出する」を選択してください PDF" アクション
- 入力パラメータを設定します(下記参照)。
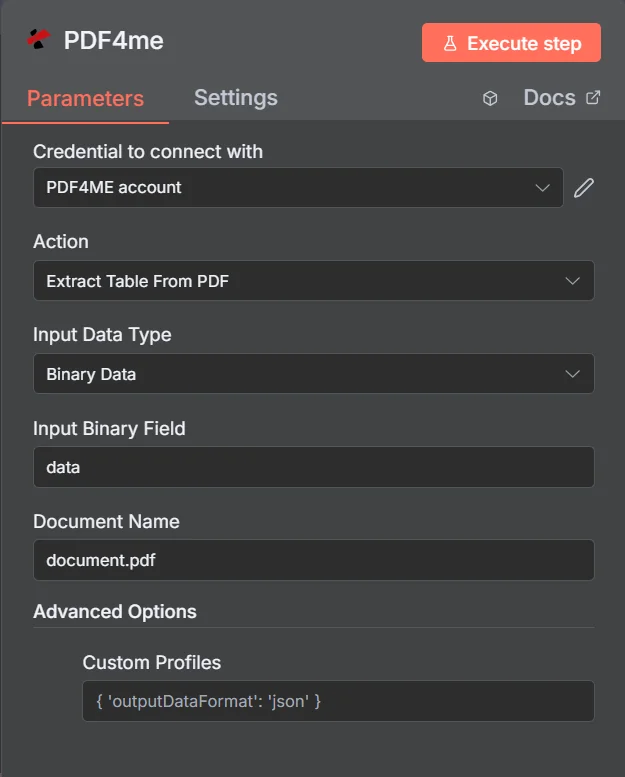
パラメータ
「Extract Table From」のパラメータ一覧 PDF アクション。これらのパラメータを設定して、テーブル抽出を制御します。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract tables from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file (usually "data" for file uploads). Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF document content. Shown when Input Data Type is Base64 String. | UEsDBBQABgAI... |
| PDF URL | Conditional | URL to the PDF file to extract tables from. Shown when Input Data Type is URL. | |
| Document Name | Optional | Name of the document (used for processing). Default is `document.pdf`. | document.pdf |
| Advanced Options | Optional | Optional settings, collapsed behind Add Option. | Add Option |
| Custom Profiles | Optional | Use 'JSON' to adjust custom properties. Review Profiles at https://dev.pdf4me.com/apiv2/documentation/ to set extra options for API calls and may be specific to certain APIs. | { "OutputDataFormat": "json" } |
出力
出力パラメータ
| 分野 | タイプ | 内容物 |
|---|---|---|
_metadata | String | Object added by the node: success (always true), message (`Table data extracted successfully`), processingTimestamp (time the node received the result, ISO 8601), sourceFileName (the input file's name for Binary Data; for URL, the last part of the URL when Document Name is empty or `document.pdf`; otherwise Document Name) and operation (`extractTableFromPdf`). |
すべての分野 PDF4me 応答はアイテムにコピーされます: テーブルは PDF (Power Automateコネクタでは tableList 各表のページ番号付き)。正確なフィールドは、 PDF4me 応答。
すべての分野の PDF4meの応答はアイテムにコピーされます: テーブルは PDF (Power Automateコネクタでは tableList 各表のページ番号付き)。正確なフィールドは PDF4meの返答。
N8N 行動対応
の PDF4me テーブルを抽出する PDF API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
[
  {
    "fileName": "table_extraction_results_1756997087699.json",
    "mimeType": "application/json",
    "fileSize": 563,
    "success": true,
    "message": "Table extraction completed successfully",
    "docName": "document.pdf"
  }
]
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| fileName | table_extraction_results_1756997087699.json |
| mimeType | application/json |
| fileSize | 563 |
| success | true |
| message | Table extraction completed successfully |
| docName | document.pdf |
スキーマビュー
レスポンスのデータ構造と型:
1 item
fileName: AB table_extraction_results_1756997087699.json
mimeType: AB application/json
fileSize: # 563
success: ☑ true
message: AB Table extraction completed successfully
docName: AB document.pdf
タイプ指標:
AB= String#= 番号☑= Boolean{}= Object[]= Array
バイナリデータビュー
実際 JSON ファイルデータとメタデータ:
data
─────────────────────────────
File Name: table_extraction_results_1756997087699.json
File Extension: json
Mime Type: application/json
File Size: 0.55 KB
JSON ファイル内容の例:
{
  "tableData": [
    {
      "headers": ["Product", "Price", "Quantity", "Total"],
      "rows": [
        ["Laptop", "$999", "2", "$1998"],
        ["Mouse", "$25", "5", "$125"],
        ["Keyboard", "$75", "3", "$225"]
      ],
      "columnCount": 4,
      "rowCount": 3
    }
  ]
}
ユースケース
データ処理と分析
- 自動データインポート生成されたファイルをダウンロードして処理します。 JSON 表形式データをデータベース、スプレッドシート、またはビジネスアプリケーションに自動的にインポートするためのファイル
- データ変換: 処理する JSON テーブルデータをさまざまなビジネスシステム向けの異なる形式に変換するファイルコンテンツ
- 統計分析: 抽出された表形式データを分析します JSON 洞察、傾向、統計レポートを生成するためのファイル
ビジネスインテリジェンスとレポート作成
- レポート自動化: 財務報告書、請求書、ビジネス文書からデータを自動的に抽出し、処理します。 JSON 自動レポート用のファイル
- ダッシュボード統合: 解析する JSON ファイルと抽出したテーブルデータをビジネスインテリジェンスダッシュボードおよび分析プラットフォームにフィードする
- データ検証: 抽出された表形式データを検証および確認します。 JSON 既存のビジネス記録に対してファイルを作成する
文書処理および管理
- 請求書処理請求書から価格表、明細項目、財務データを抽出し、生成されたデータを処理する。 JSON 自動処理用のファイル
- 契約分析ダウンロード可能なツールを使用して、契約書や法的文書から条項、条件、構造化データを抽出します。 JSON ファイル
- 在庫管理製品カタログ、在庫リスト、サプライチェーンデータを処理します。 PDF 文書を JSON 出力ファイル
エンタープライズ統合
- システム統合ダウンロードして統合します JSON 既存のエンタープライズシステムとファイルを共有する ERP、 CRM、およびデータウェアハウス
- ワークフロー自動化: に基づいて自動化されたワークフローをトリガーします JSON ファイル処理と抽出された表形式データ
- データ同期: 処理する JSON 抽出したデータを複数のシステムとプラットフォーム間でファイルおよび同期して、一貫性のある情報管理を実現する