リソースを抽出する PDF 使用 n8n アクション
PDF4me リソースを抽出する テキストコンテンツと埋め込み画像を抽出します PDF 文書を通じて n8n 自動化ワークフロー。プロセス PDF離れて n8n トリガー、バイナリデータ、base64文字列、または公開 URLページ固有のターゲティング、選択的な抽出オプション(テキストのみ、画像のみ、または両方)、および構造化された出力フォーマットを使用して、テキスト、画像、グラフィック、および視覚要素を自動的に抽出します。このソリューションは、柔軟なターゲティングとシームレスな統合による正確なコンテンツ抽出を必要とする、コンテンツの再利用、画像抽出、テキスト分析、文書のデジタル化、コンテンツの移行、およびリソースの復旧ワークフローに最適です。
設定
追加する PDF4me 「リソースの抽出」ノードを n8n ワークフローを実行し、必要なパラメータを設定します。初期設定手順については、こちらをご覧ください。 n8n 統合ガイド。
前提条件:
- PDF4me API 資格
- n8n ワークフローへのアクセス
構成:
- 追加 PDF4me ノードからワークフローへ
- 「リソースの抽出」アクションを選択します。
- 入力パラメータを設定します(下記参照)。
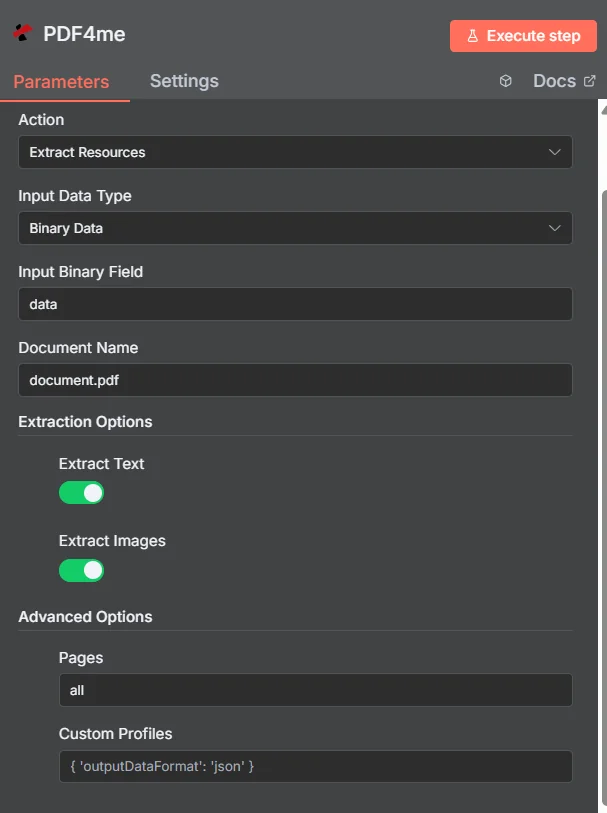
パラメータ
リソース抽出アクションのパラメータ一覧です。これらのパラメータを設定することで、リソース抽出を制御できます。
重要: アスタリスク(***)が付いているパラメータは必須であり、アクションが正しく機能するためには必ず指定する必要があります。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract resources from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file (usually "data" for file uploads). Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF document content. Shown when Input Data Type is Base64 String. | JVBERi0x... |
| PDF URL | Conditional | URL to the PDF file to extract resources from. Shown when Input Data Type is URL. | https://abc.com/xyz.pdf |
| Document Name | Optional | Name of the document (used for processing). Default is `document.pdf`. | document.pdf |
| Extract Text | Optional | Whether to extract text content from the PDF. Default is `Yes`. | Yes |
| Extract Images | Optional | Whether to extract images from the PDF. Default is `No`. | No |
| Return Images as Binary | Optional | Whether to return extracted images as binary data in addition to JSON metadata. Default is `No`. | No |
| Binary Data Name | Conditional | Prefix of the binary properties for the images: they are stored as `<name>_1`, `<name>_2` and so on. Shown when Return Images as Binary is enabled. Default is `image`. | image |
| Advanced Options | Optional | Optional settings, collapsed behind Add Option. | Add Option |
| Pages | Optional | Pages to extract resources from: `1,2` for specific pages, `2-5` for a range, or `all`. If the page selection fails, the whole document is used without an error. Default is `all`. | all |
| Custom Profiles | Optional | Use 'JSON' to adjust custom properties. Review Profiles at https://dev.pdf4me.com/apiv2/documentation/ to set extra options for API calls and may be specific to certain APIs. | { "outputDataFormat": "json" } |
出力
出力パラメータ
| 分野 | タイプ | 内容物 |
|---|---|---|
_metadata | String | Object added by the node: success (always true), message (`Resources extracted successfully`), processingTimestamp (time the node received the result, ISO 8601), sourceFileName (the Document Name field as entered) and operation (`extractResources`). |
data | Binary | Only when Extract Images and Return Images as Binary are both on and PDF4me returns image data: one binary property per image, named `<Binary Data Name>_1`, `<Binary Data Name>_2` and so on. |
すべての分野 PDF4me 応答はアイテムにコピーされます: 抽出されたテキストと画像 (Power Automate コネクタ内) texts1ページに1項目、 images); 画像は JSON バイナリとして返される場合でも、正確なフィールドは PDF4me 応答。
すべての分野の PDF4meの応答はアイテムにコピーされます: 抽出されたテキストと画像 (Power Automate コネクタ内) texts1ページに1項目、 images); 画像は JSON バイナリとして返される場合でも、正確なフィールドは PDF4meの返答。
N8N 行動対応
の PDF4me リソースを抽出する API 複数の形式で表示可能なレスポンスを返します。ニーズに最適な表示形式を選択してください。
- JSON
- Table
- Schema
- Binary
JSON 回答形式
生 JSON からの応答 API:
{
  "fileName": "extracted_resources_1756999816629.json",
  "mimeType": "application/json",
  "fileSize": 1945,
  "success": true,
  "message": "Resource extraction completed successfully",
  "docName": "document.pdf"
}
テーブルビュー
構造化された表形式の応答データ:
| パラメータ | 価値 |
|---|---|
| fileName | extracted_resources_1756999816629.json |
| mimeType | application/json |
| fileSize | 1945 |
| success | true |
| docName | document.pdf |
| message | Resource extraction completed successfully |
スキーマビュー
レスポンスのデータ構造と型:
fileName: AB extracted_resources_1756999816629.json
mimeType: AB application/json
fileSize: # 1945
success: ✓ true
docName: AB document.pdf
message: AB Resource extraction completed successfully
タイプ指標:
AB= String#= 番号✓= Boolean
バイナリデータビュー
実際に抽出されたコンテンツデータとメタデータ:
data
─────────────────────────────────────────
File Name: extracted_resources_1756999816629.json
File Extension: json
Mime Type: application/json
File Size: 1.9 KB
ユースケース
コンテンツ管理システム: テキストと画像を抽出します PDF 文書を一元管理するコンテンツリポジトリ向けに作成し、文書コンテンツの検索可能なデータベースを実現します。
データ処理パイプライン: 構造化データを自動的に抽出します PDF ビジネスインテリジェンスツールや分析プラットフォームとの連携を目的としたレポート、請求書、および各種フォーム。
文書分析: 大量の PDF コンプライアンス監視、調査、および自動レポート作成のために特定の情報を抽出するための文書。
アーカイブのデジタル化: レガシーを変換する PDF アーカイブを検索可能な構造化データに変換し、最新のコンテンツ管理システムや知識発見システムに活用する。