フォームデータを抽出する PDF で n8n
フォームデータを抽出する PDF は PDF4me ノードアクション n8n 入力可能なフィールドから入力済みの値を読み取る PDF そしてそれらを構造化された形で返します formData JSON オブジェクト。返送された申請書、署名済みの受付シート、またはアンケートを変換するために使用します。 PDFs 回答を再入力することなく、データベースの行に反映されます。
このノードの機能
PDF4me: フォームデータを抽出 PDF 記入済みのフォーム PDF バイナリデータから、 Base64 Stringまたは URLインタラクティブなフォームレイヤーを読み取り、すべてのフィールドを単一の名前と値のペアとして返します。 フォームデータ オブジェクト。テキスト入力、チェックボックス、ラジオボタン、ドロップダウン選択はすべて再び集まり、スプレッドシートの行にマッピングする準備が整います。 CRM レコード、またはワークフロー内の条件分岐。
認証 API リクエスト
毎 PDF4me ノード n8n 有効な 接続するための認証情報. 作成または選択して、 PDF4me API ワークフローが抽出要求を安全に認証できるようにするためのキー。
見逃してはならない重要な事実
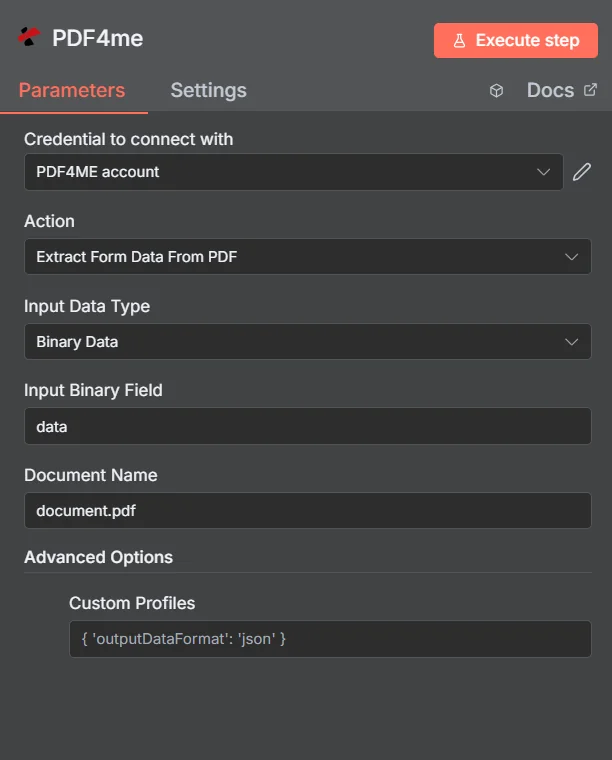
PDF4me フォームデータを抽出する PDF パラメーターパネル n8n
フォームデータ抽出とプレーンテキスト抽出の比較
どちらのアプローチも、 PDFしかし、名前付きフィールドを提供するのはどちらか一方だけです。この違いによって、ワークフローに含めるべきノードが決まります。
| アプローチ | 返ってくるもの | 最適なフィット感 |
|---|---|---|
| Extract Form Data From PDF | Named field and value pairs from the interactive form layer | Genuine fillable PDFs where every answer already sits in a named field |
| Plain text extraction | The visible page content as one flat string, with no field names | Static PDFs with no form layer, where you will parse the text yourself |
| AI document parsing | Model-inferred fields from any layout, including scans | Scanned, flattened, or wildly inconsistent documents with no usable form structure |
フォームデータ抽出はどのパラメータから行われますか? PDF 必要?
必須: アクション、入力データタイプ、その入力タイプに一致するフィールド、およびドキュメント名。詳細オプションのカスタムプロファイルはオプションです。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Input Data Type | Required | Choose how to provide the PDF file to extract form data from. Options: Binary Data, Base64 String, URL. Default is `Binary Data`. | Binary Data |
| Input Binary Field | Conditional | Name of the binary property that contains the PDF file (usually "data" for file uploads). Shown when Input Data Type is Binary Data. Default is `data`. | data |
| Base64 PDF Content | Conditional | Base64 encoded PDF document content. Shown when Input Data Type is Base64 String. | JVBERi0xLjQK... |
| PDF URL | Conditional | URL to the PDF file to extract form data from. Shown when Input Data Type is URL. | |
| Document Name | Optional | Name of the document (used for processing). Default is `document.pdf`. | document.pdf |
| Advanced Options | Optional | Optional settings, collapsed behind Add Option. | Add Option |
| Custom Profiles | Optional | Use 'JSON' to adjust custom properties. Review Profiles at https://dev.pdf4me.com/apiv2/documentation/ to set extra options for API calls and may be specific to certain APIs. | { 'outputDataFormat': 'json' } |
出力フィールド
成功したランは1 n8n 抽出されたフォーム値を保持するアイテムとして JSON。
典型的なレスポンスボディは次のようになります。
{
  "formData": {
    "name": "PDF4me",
    "email": "",
    "country": "USA"
  }
}
出力
ノードが返すフィールド。
| 分野 | タイプ | 内容物 |
|---|---|---|
_metadata | String | Object added by the node: success (always true), message (`Form data extracted successfully`), processingTimestamp (time the node received the result, ISO 8601), sourceFileName (the input file's name for Binary Data, the last part of the URL for URL, and Document Name for Base64) and operation (`extractFormDataFromPdf`). |
すべての分野 PDF4me レスポンスはアイテムにコピーされます: フォームフィールドの値は PDF (Power Automate コネクタでは traceId と formData オブジェクト)。フィールド名はフォームによって異なります。正確なフィールドは、 PDF4me 応答。
すべての分野の PDF4meの応答はアイテムにコピーされます: フォームフィールドの値は PDF (Power Automate コネクタでは traceId と formData オブジェクト)フィールド名はフォームによって異なります。正確なフィールドは PDF4meの返答。
フォームデータ抽出の設定方法 PDF で n8n?
- 追加 PDF4me あなたの n8n ワークフローを選択し、 フォームデータを抽出する PDF アクション。
- で 接続するための認証情報選択してください PDF4me 認証情報またはクリック 新しい認証情報を作成する そしてあなたの API 鍵。
- セット 入力データタイプ に バイナリデータ (デフォルト)、 Base64 String、 または URL 対応する充填済み PDF 分野。
- セット 文書名 例えば、ソースファイル名に
application_form.pdf。 - 離れる カスタムプロファイル 下 詳細オプション 特定の処理プロファイルが必要な場合を除き、空白のままにしてください。
- ノードを実行し、返された値から値をマッピングします。
formDataオブジェクトをワークフローの次のステップに進めます。
典型的な構成
ワークフローの例Common n8n workflow patterns using Extract Form Data From PDF.
- 申請が完了するとメールが送信されます PDF 到着する。
- フォームデータを抽出する PDF 添付ファイルをformDataオブジェクトに読み込みます。
- Google スプレッドシートまたは Excel ノードは行を1つ追加し、各フィールド名を列にマッピングします。
- クラウドストレージのトリガーが、新しくアップロードされたデータに基づいて作動する PDF。
- フォームデータを抽出する PDF フォームレイヤーから連絡先情報を取得します。
- A CRM ノードは、抽出された名前、メールアドレス、および会社名を使用してレコードを作成または更新します。
- ウェブフックは、外部ポータルから署名済みのリクエストフォームを受信します。
- フォームデータを抽出する PDF 要求された金額と部門フィールドを返します。
- IFノードは、これらの値に基づいて適切な承認者へと分岐します。
- アイテムのループノードは、アーカイブされたフォームのリストを反復処理します。 URLs。
- フォームデータを抽出する PDF 入力データタイプを次のように設定して実行します URL ファイルごとに。
- 各formDataオブジェクトは、ソースドキュメント名をキーとするデータベーステーブルに書き込まれます。
実践的なヒント
チートシート
| 分野 | 価値 |
|---|---|
| Action | Extract Form Data From PDF |
| Input Data Type | Binary Data |
| Input Binary Field | data |
| Document Name | document.pdf |
| Custom Profiles | { 'outputDataFormat': 'json' } |
| Credentials | PDF4me API credential |
| Returns | formData object of field name and value pairs |