Word からテキストを抽出する Make: クリーンなテキスト検索 PDF4me
PDF4me ワードからテキストを抽出する は Make Word文書からテキストコンテンツを抽出するモジュールです。ページ範囲の制御機能に加え、コメント、ヘッダー、フッターの削除、変更履歴の確定といったオプションも備えています。Wordを開かずに、クリーンなテキストを検索インデックス、翻訳サービス、テキストマイニングパイプラインに供給するために活用できます。
このモジュールの機能
PDF4me ワードからテキストを抽出する .docx ファイルのテキストコンテンツをドキュメントテキストフィールドに返します。必要に応じてページ範囲を指定したり、コメント、ヘッダー/フッターを削除したり、変更履歴を優先的に処理したりして、テキストを整理します。この操作一つで、ドキュメントを開いてテキストをコピーする手間が省けます。
関連ブログ記事
この機能に関するブログ記事はまだありません。近日公開予定です。
その間、PDF4me ブログを閲覧して、あらゆるプラットフォームのチュートリアルやワークフローをご覧ください。
ブログをご覧ください →
認証方法 Make シナリオ?
毎 PDF4me モジュール Make 有効な 繋がり. 作成または選択して、 PDF4me API シナリオがテキスト抽出要求を安全に認証できるようにするためのキー。
見逃してはならない重要な事実
変更の承認は抽出後ではなく、抽出前に実行されます。
「変更を承認」を設定すると、ドキュメント内のすべての変更履歴が最初に確定され、抽出されたテキストは編集後のバージョンを反映します。ソースに修正マークが論理的に残っているテキストが必要な場合は、この設定をオフにしてください。
ページ範囲は任意であり、必須ではありません。
開始ページ番号と終了ページ番号を指定すると、抽出対象ページを絞り込むことができます。両方とも空欄にすると、文書全体を一度に抽出できます。
ドキュメントバッファフィールドには「Jsonファイル」というラベルが付いています。
名前とは裏腹に、Json ファイルには Word 文書のマッピングされたバイナリ コンテンツが格納されており、 JSON テキスト。他のファイルバッファと全く同じようにマッピングします。 PDF4me モジュール。
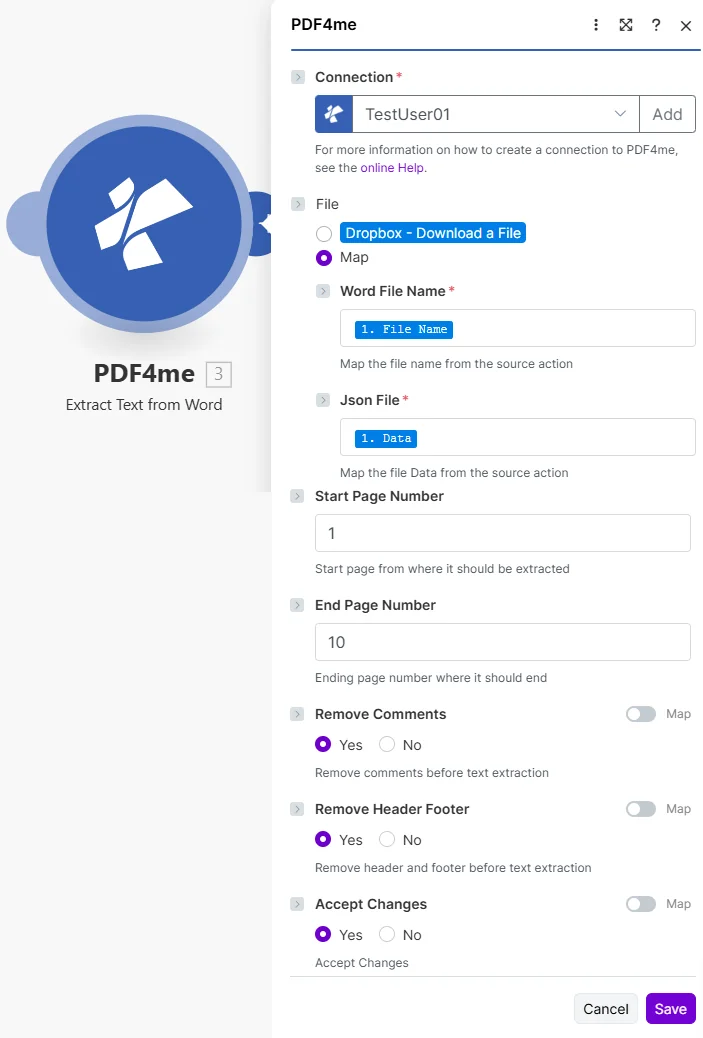
ファイル設定をマップに設定し、前のモジュールからWordファイル名とJSONファイルを接続し、オプションのページ範囲とクリーンアップの切り替えを設定します。
パラメータ
必須: 接続情報とファイルは必ず指定する必要があります。ファイルがマップの場合は、Wordファイル名とJSONファイルが必須です。ページ範囲とクリーンアップの切り替えはオプションです。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Connection | Required | PDF4me API connection. Click Add and paste your API key if connecting for the first time. | TestUser01 |
| File | Required | Radio button picking how the source Word document arrives. Pick a quick storage option (Dropbox - Download a File) or choose Map to bind Word File Name and Json File from any prior module. | Map |
| Word File Name | Required | Filename of the source document including its .docx extension. Shown as a sub-field of File when Map is selected. | annual_report.docx |
| Json File | Required | Binary content of the Word document, mapped from the prior module Data output despite the Json label. Shown as a sub-field of File when Map is selected. | [Word Buffer] |
| Start Page Number | Optional | Page number where extraction begins. Defaults to 0. Hint: "Start page from where it should be extracted." | 1 |
| End Page Number | Optional | Page number where extraction ends. Defaults to 0. Hint: "Ending page number where it should end." | 10 |
| Remove Comments | Required | Strips reviewer comments from the extracted text when enabled. Defaults to No. | Yes |
| Remove Header Footer | Required | Excludes running headers and footers from the extracted text when enabled, leaving only body content. Defaults to No. | Yes |
| Accept Changes | Required | Finalizes all tracked changes before extraction when enabled, so the text reflects the edited version. Defaults to No. | Yes |
出力フィールド
PDF4me リクエストをバックグラウンドジョブとして処理し、 Make 次のモジュールを実行する前に、結果を待ちます。
| 分野 | タイプ | 内容物 |
|---|---|---|
Job Id | Text | ID of the PDF4me job that processed the request. |
Doc Text | Text | Complete text content from the Word document, filtered by the page range and cleanup options selected. |
Document | File (binary data) | The extracted text as a file (binary data). |
Word からテキストを抽出する設定方法 Make?
- 追加 PDF4me → ワードからテキストを抽出する あなたの Make シナリオ。
- 選択 繋がり (またはクリック) 追加 あなたと一緒に作成する PDF4me API 鍵)。
- 下 ファイル、 選ぶ 地図 ワイヤー Wordファイル名 そして JSONファイル 前のモジュールから(Dropbox、Google Drive、またはメール添付ファイルから)。
- オプションで設定可能 開始ページ番号 そして 最終ページ番号 抽出対象をページ範囲に限定する。
- 切り替え コメントを削除、 ヘッダーとフッターを削除、 そして 変更を受け入れる 必要に応じて。シナリオを実行すると、抽出されたテキストが返されます。 ドキュメントテキスト。
典型的な構成
ワークフローの例Common Make scenario patterns using Extract Text from Word.
契約条項検索インデックス
- 署名済みの契約がリポジトリに格納されると、トリガーが作動します。
- 「ファイル取得」は、実行済みのWord契約書をダウンロードします。
- Wordからテキストを抽出する処理は、「変更を承認」と「コメントを削除」を有効にして実行され、クリーンな最終バージョンが作成されます。
- 抽出されたテキストは、検索可能なデータベースまたは全文索引に書き込まれる。
- 後続の正規表現または自然言語処理のステップで、キーワード、日付、および関係者が抽出されます。
翻訳準備
- プロジェクトトラッカーで、翻訳対象として文書がマークされます。
- 「ファイルの取得」は、ソースとなるWordファイルを取得します。
- Wordからテキストを抽出する際は、本文コンテンツを分離するために「ヘッダーとフッターを削除」機能を有効にして実行します。
- クリーンなテキストが翻訳に送られます API。
- 翻訳されたテキストは新しい文書として再構築され、原文とともにアーカイブされます。
レガシーコンテンツの移行
- 移行のために、アーカイブフォルダから古いWord文書が取り出されます。
- Wordからテキストを抽出する機能は、1回の呼び出しでテキストコンテンツ全体を取得します。
- このシナリオでは、返されたテキストから見出しと段落を解析します。
- CMSの「エントリ作成」ステップでは、コンテンツを新しいプラットフォームにインポートします。
- 元の文書はアーカイブ内で移行済みとしてタグ付けされています。
実践的なヒント
Enable Accept Changes for a final-version extract
If the source document still has open tracked changes, leaving Accept Changes off can pull ambiguous or duplicated text. Turn it on whenever you want the clean, finalized wording.
Use the page range for large documents
Setting Start Page Number and End Page Number avoids pulling an entire multi-hundred-page manual when you only need a specific section.
Remove Header Footer before search indexing
Repeated headers and footers pollute keyword frequency in search indexes and NLP pipelines. Strip them for cleaner downstream analysis.
Map Json File like any other buffer
The label is misleading, it is not a JSON string. Map the binary Data output from the prior module the same way you would for any PDF4me file input.
Pair with Parse JSON only after your own restructuring
Doc Text is plain text, not structured JSON. If you need individual fields, run your own regex or AI parsing step against Doc Text first.
チートシート
| 分野 | 価値 |
|---|---|
| Module | Extract Text from Word |
| Connection | PDF4me API key |
| Document source | File = Map (Word File Name + Json File) |
| Page range | Start Page Number / End Page Number (optional) |
| Cleanup toggles | Remove Comments / Remove Header Footer / Accept Changes |
| Output | Job Id, Doc Text, Document |
よくある質問
業界におけるユースケースとアプリケーション
- Legal & Compliance
- Content Management
- Translation & Localization
- Research & Analytics
- 契約分析契約分析用のテキストを抽出します
- 法律調査: 法的文書から判例を探し出す
- コンプライアンスレビュー: コンプライアンスチェック用のテキストを抽出します
- 発見: 電子情報開示のためのコンテンツ抽出
- CMS移行コンテンツ管理システム用のテキスト抽出
- 知識ベース検索可能な知識リポジトリを構築する
- アーカイブのデジタル化: レガシー文書からテキストを抽出する
- コンテンツの再利用: 再利用のためにコンテンツを取得する
- 翻訳準備翻訳サービス用のテキストを抽出します。
- 多言語コンテンツローカライズ用のテキストを準備する
- 言語処理: 自然言語処理分析用のテキストを抽出します
- コンテンツのグローバル化国際市場向け処理テキスト
- テキストマイニングデータマイニング用のテキストを抽出する
- 感情分析: 文書の感情分析
- コンテンツ分析: 研究資料のテーマとトピック
- 研究データ: 分析のために研究内容を抽出します
関連アクション
メタデータの抽出
抽出した本文テキストとともに、文書のプロパティ(作成者、タイトル、日付)を取得します。
文書を比較する
2つのWordバージョンを直接比較できます。これは、全文ではなく変更点だけを確認したい場合に便利な方法です。
式によるテキスト抽出
文書全体ではなく、パターンに一致するテキストのみを抽出します。
他のプラットフォームでの同じタスク
n8n: Word からテキストを抽出する
同じテキスト抽出ノード n8n ワークフローを自己ホスト型またはクラウドに接続します n8n インスタンスの代わりに Make。
Power Automate: Word からテキストを抽出する
Microsoft に対しても同様のテキスト抽出アクション Power Automate 流れ、適合する SharePoint そしてOneDriveのワークフロー。
Zapier: Word からテキストを抽出する
テキスト抽出の手順は同じです ZapierGoogle Sheets、Airtable、または CRM 既にZapに登録されているトリガー。
PDF4me API: Word からテキストを抽出する
同じテキスト抽出エンドポイントを直接呼び出すには REST カスタム統合の場合 Make。