画像からテキストを抽出する - OCR のために Make
PDF4me 画像からテキストを抽出する モジュールは自動化された OCR テキスト抽出 JPG、 PNG、 TIFF、 そして BMP 画像内 Make さまざまなシナリオに対応します。このインテリジェントな認識サービスは、スキャンされた文書、テキスト付きの写真、スクリーンショット、画像ベースのコンテンツを編集可能なテキストに変換し、クラウドストレージプラットフォームやビジネスアプリケーション全体で、データ抽出、文書のデジタル化、自動データ入力、コンテンツ分析のワークフローを可能にします。
関連ブログ記事
この機能に関するブログ記事はまだありません。近日公開予定です。
その間、PDF4me ブログを閲覧して、あらゆるプラットフォームのチュートリアルやワークフローをご覧ください。
ブログをご覧ください →
APIリクエストの認証
アクセスするには PDF4me ウェブ API を通して Makeすべてのリクエストには適切な認証情報を含める必要があります。認証により安全な通信が保証され、承認されたユーザーとしての身元が検証され、シームレスな統合が可能になります。 Make シナリオと PDF4meの強力な OCR サービス。
主な機能
- OCR テクノロジー高度な光学文字認識
- フォーマットサポート: 抜粋 JPG、 PNG、 TIFF、 そして BMP 画像
- 編集可能なテキスト機械可読なテキストコンテンツを返します
- バッチ処理イテレータを使用して複数の画像を処理する
- データマイニング画像ベースのドキュメントからデータを抽出する
パラメータ
画像からテキストを抽出するモジュールのパラメータ一覧。
重要: アスタリスク(***)が付いているパラメータは必須であり、モジュールが正しく機能するためには必ず指定する必要があります。
| パラメータ | タイプ | 説明 | 例 |
|---|---|---|---|
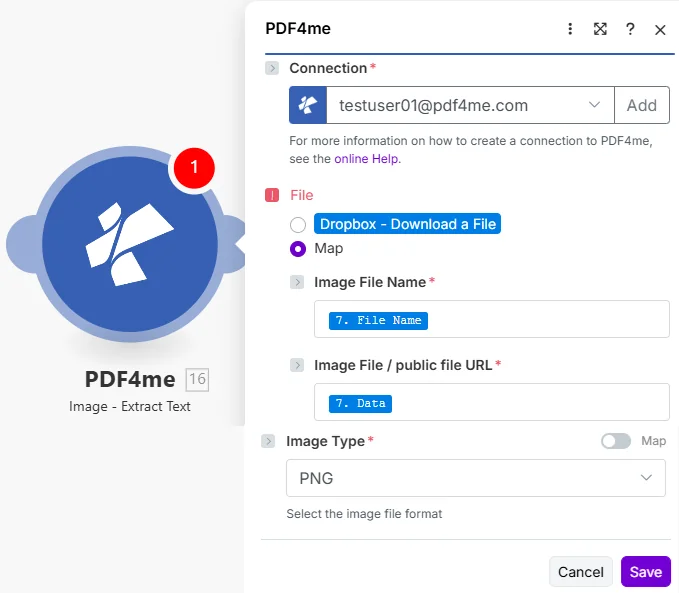
| ファイル*** | Radio | ソースイメージがモジュールに到達する方法 • ラジオボタンには、接続されているストレージの操作 (Dropbox - ファイルのダウンロードなど) とマップが表示されます。 • マップを選択して、以前のモジュールから以下のフィールドを接続します • 画像ファイル名と画像ファイル/公開ファイルのURLは、マップが選択された後のみ表示されます。 | Map |
| 画像ファイル名*** | File name | 画像ファイル名 | scan.jpg |
| 画像ファイル / 公開ファイルURL*** | File (binary data) | 画像コンテンツ ・前のモジュールからのファイルデータをマッピングする ・または公共のアクセス可能な場所に入る URL ファイルの | [Image Buffer] |
| 画像タイプ*** | Dropdown | 形式 • JPG、 PNG、 TIFF、 または BMP • デフォルトはPNG形式 | JPG |
出力
の PDF4me 画像からテキストを抽出する このモジュールは認識されたテキストを返します。
| 分野 | タイプ | 内容物 |
|---|---|---|
| 文章 | 文章 | 画像内で認識されたテキスト。 |
PDF4me リクエストをバックグラウンドジョブとして処理し、 Make 次のモジュールを実行する前に、結果を待ちます。