抽出する PDF フォームデータ Make
このモジュールの機能
の PDF4me 抽出する PDF フォームデータ モジュールは、入力済みのデータを読み取ります。 PDF フォームからすべてのフィールド名とその値、テキスト入力、チェックボックス、ドロップダウン、ラジオボタンを抽出します。 Make シナリオ。手動でのデータ入力、値のコピーは不要です。 PDFs抽出されたデータは構造化された出力として返され、データベース、スプレッドシート、 CRMまたは、下流のモジュール。
認証 API リクエスト
毎 PDF4me モジュール Make 有効な 繋がり あなたのサポートにより PDF4me API キー。このモジュールにファイルをマッピングする前に、接続を追加または選択してください。
見逃してはならない重要な事実
ラベルの付いたフィールド ドキュメント/公開ファイルのURL バイナリ形式も受け入れます PDF 前のモジュールからのバッファ そして 直接公開URL PDF ファイル。どちらでもマッピングできますが、 PDF 実際に入力済みのフォームフィールドが含まれており、空の空白フォームではありません。
このモジュールはフォームフィールドのみを読み取ります。自由形式のテキスト、注釈、またはインタラクティブなフォームフィールド以外のコンテンツは抽出しません。 PDF 実際の画像ではなく、スキャンした画像の上にタイプされたテキストを使用する PDF フォームフィールドを使用する PDF OCR または ドキュメントを解析する 代わりにモジュールを使用してください。
出力は、すべてのフィールドをキーと値のペアとして返します。フィールド名は、 PDF 作成者が名前を付けたものは、多くの場合、次のような技術的なIDです。 フィールド_001 読みやすいラベルではなく。サンプルでテストしてください。 PDF まず、下流のロジックを構築する前に、フィールド名をマッピングする必要があります。
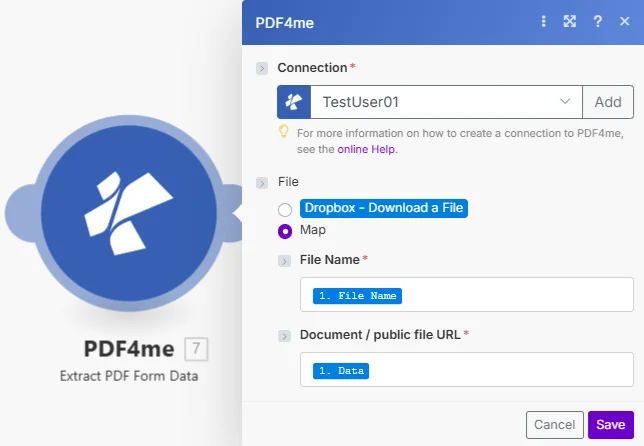
マップが選択されました ファイル名 そして ドキュメント/公開ファイルのURL これは前のモジュールの出力、通常はDropbox、Google Driveからのダウンロード手順、または電子メールの添付ファイルから取得されます。
パラメータ
必須: 繋がり、 ファイル名、 そして ドキュメント/公開ファイルのURL すべて必須項目です。オプションのパラメータはありません。
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| Connection | Required | PDF4me API connection for the scenario. | Your PDF4me connection |
| File | Required | How the PDF is supplied: Dropbox module or Map from a prior step. | Map |
| File Name | Required | Filename of the filled PDF, mapped from the prior step. | 1. File Name |
| Document / public file URL | Required | The filled PDF as a binary buffer or a public URL. The UI accepts both file data and a public file URL. | 1. Data |
出力
PDF4me リクエストをバックグラウンドジョブとして処理し、 Make 次のモジュールを実行する前に、結果を待ちます。
| 分野 | タイプ | 内容物 |
|---|---|---|
Form Data | Any (structured data) | The values of the form fields in the PDF, as structured data. Parse it downstream to reach individual field values. |
ワークフローの例
ワークフローの例Three common ways teams use Extract PDF Form Data inside Make.
記入済みの申請書が添付されたメールが届きます。 PDF → 抽出する PDF フォームデータ → FirstName、Email、Position フィールドをマッピングする → Airtable に行を作成する → 応募者に確認メールを送信する。
Dropboxの監視機能が新たな事態を検知 PDF アップロード → 抽出する PDF フォームデータ → すべてのフィールド値を Google スプレッドシートの新しい行として追加する → サマリー ダッシュボードを更新する → アーカイブする PDF。
ファックスから電子メールでスキャンされた注文書が送信されます PDF → 抽出する PDF フォームデータ → 必須項目が入力されていることを確認する → 注文レコードを作成する CRM → 顧客に注文確認メールを送信する。