添付ファイルを抽出する PDF で Make
添付ファイルを抽出する PDF は Make モジュールは、内部に埋め込まれたすべてのファイルを取得します。 PDF シナリオ内で自動的に文書化します。 PDF ポートフォリオ、標準 PDF 添付ファイル、 PDF/A-3 ソースファイルを取得し、抽出された各ファイルを添付ファイル配列の項目として返します。この配列は、イテレータが個別に処理できるようになっています。
このモジュールは、すべての添付ファイルを単一の出力バンドル内の配列として返します。 Make イテレータ 直後のモジュールで配列を個別のバンドルに分割します。各バンドルには、添付ファイルごとに1つずつ含まれます。 ファイル名 そして 書類添付ファイルはバイナリファイルの内容として扱われるため、ファイルの種類や名前に基づいて異なる宛先にファイルをルーティングできます。
抽出された各添付ファイルはバイナリファイルコンテンツとして返されます。 書類 フィールドにその名前が付けられている ファイル名ペアを直接マッピングします Make ストレージ統合(Google Drive、Dropbox、OneDrive)またはメール添付ファイルとして送信され、マッピング前に変換手順は不要です。
標準を超える PDF 添付ファイル、このモジュールが処理します PDF ポートフォリオ (複数ファイルコンテナ) PDF/A-3 埋め込みソースファイルを含むアーカイブ文書。 PDF/A-3ソースファイル(Word、 Excel、 XML) はアーカイブ中に抽出されます PDF コンプライアンス保管中はそのままの状態です。 PDF/A-3 仕様。
認証 API リクエスト
アクセスするには PDF4me ウェブ API を通して Makeすべてのリクエストには適切な認証情報を含める必要があります。認証により、お客様とお客様の間の安全な通信が保証されます。 Make シナリオと PDF4me添付ファイル抽出サービス。
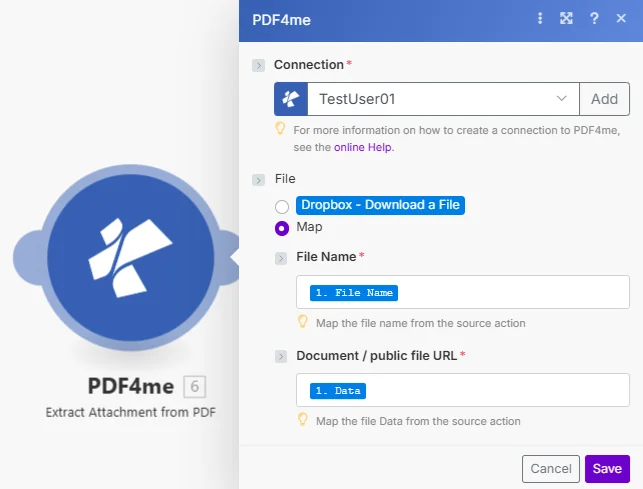
地図 ファイル名 そして 書類 前のダウンロード手順から、次にチェーンします Make イテレータ 抽出された各添付ファイルを処理する。
添付ファイルの抽出方法の設定方法 PDF で Make
- 追加 PDF4me > 添付ファイルを抽出する PDF あなたのシナリオに当てはめて。
- 選択してください 繋がり またはクリック 追加 あなたと一緒に作成する API 鍵。
- 地図 ファイル名 (拡張子.pdf付き)前のモジュールから取得するか、静的な名前を入力してください。
- 地図 書類 (バイナリ) PDF Google Drive、Dropbox、メール、またはバッファから HTTP ダウンロード手順。
- 追加する Make イテレータ このモジュールの後にマッピングして、 添付ファイル 配列出力。
- 下流モジュールをイテレータの出力に接続します。クラウドストレージへのアップロード、メール送信、データのインポート、ファイルタイプによるルーティングなどが可能です。
パラメータ
| パラメータ | 必須 | その機能 | 例 |
|---|---|---|---|
| File | Required | How the source PDF reaches the module. The radio lists your connected storage actions (for example Dropbox - Download a File) and Map. Choose Map to wire the fields below from earlier modules: File Name and Document / public file URL only appear once Map is selected. | Map |
| File Name | Required | Filename of the source PDF including the .pdf extension. Map from the previous module's file name output or enter a static name. | portfolio.pdf |
| Document / public file URL | Required | Binary PDF file content. Map from a Google Drive, Dropbox, email, or HTTP download step. The PDF must contain embedded attachments for the module to return results. | [PDF Buffer] |
出力
PDF4me リクエストをバックグラウンドジョブとして処理し、 Make 次のモジュールを実行する前に、結果を待ちます。
| 分野 | タイプ | 内容物 |
|---|---|---|
Attachments | Array | Collection of all extracted attachment objects. Feed into a Make Iterator to process each file individually. |
Attachments[].File Name | File name | Filename of the individual attachment including its extension (e.g. source_data.xlsx). |
Attachments[].Document | File (binary data) | Content (binary data) of the individual attachment. Map it into a storage upload module or an email attachment. |
Attachments[].Document Url | Text | Link to the attachment, when the file is returned as a URL. |
どのようなファイルタイプを抽出できますか PDF?
添付ファイルとして埋め込まれたファイルの種類はすべてサポートされています: スプレッドシート (XLSX、 CSV)、Word文書(DOCX)、画像(PNG、 JPG)、ZIPファイル、またはその他の PDFsこれには以下のファイルが含まれます。 PDF ポートフォリオ (Adobeのマルチファイルコンテナフォーマット)およびソースファイルが埋め込まれています PDF/A-3 アーカイブは ISO 19005-3 標準このモジュールは、返されるファイル名フィールドに元のファイル形式と拡張子を保持します。
ワークフローの例
- Compliance Extraction
- PDF/A Source Recovery
- Portfolio Distribution
コンプライアンス提出書類から証拠ファイルを抽出して整理する PDFs
- トリガーコンプライアンス提出 PDF 受信しました(メール添付ファイルまたはウォッチフォルダ)
- ダウンロード PDFコンプライアンスパッケージを取得する
- 添付ファイルを抽出埋め込まれた証拠ファイルをすべて取得する
- イテレータ抽出した添付ファイルをそれぞれ個別に処理する
- 拡張分類適切なコンプライアンスフォルダ(スプレッドシート、画像、ドキュメントなど)へルーティングする
- アップロード各ファイルを正しいフォルダに保存します。 SharePoint またはGoogleドライブ
- ログ抽出したすべてのファイルをコンプライアンスデータベースに記録する
- チームに通知する処理済みの提出書類についてコンプライアンスチームに通知する
編集可能なソースファイルを取得する PDF/A-3 アーカイブ文書
- トリガー: PDF/A-3 アーカイブ文書には埋め込みソースファイルが必要です
- アーカイブをダウンロード PDF: 取得する PDF/A-3 コンプライアンスストレージからの文書
- 添付ファイルを抽出: 埋め込みを取得する Excel またはWordソースファイル
- 検証する抽出されたファイルが完了したことを確認します。
- ソースファイルをアップロード編集可能なファイルフォルダに保存する
- 依頼者に通知する抽出したソースファイルのリンクを送信します
開封する PDF ポートフォリオを作成し、適切なチームにファイルを配布する
- トリガー: PDF クライアントからポートフォリオを受け取りました
- ポートフォリオをダウンロードポートフォリオを取得する PDF
- すべての添付ファイルを抽出: 埋め込まれたすべてのファイルを取得します
- イテレータ: 抽出された各ファイルを処理します
- ファイルタイプによるルーティング各ファイルを適切なチームフォルダに送信してください。
- 個別にメールを送信各ファイルを指定された受信者に配信する
- 確認する: ポートフォリオが処理され、配布されたことを送信者に通知します。